
Pingboは対応が必要なメールをどう見分けるのか
Pingboは使う人にとって何が大切かを学び、対応済みの仕事、返事を待っている仕事、まだ対応が必要な仕事を整理します。時間のあるときに確認できるので、新着メールのたびに手を止める必要はありません。
Pingboの役割は、受信トレイから本当に重要なメールを見つけ、それ以外はそっとしておくことです。言葉にすると単純ですが、正しく判断するのは難しい仕事です。
Pingboのほかの機能も、この判断が正しいことを前提にしています。返信の下書きが役立つのは、実際に返信を求められている場合です。フォローアップの予定も、本当に相手の返事を待っていなければ意味がありません。必要なメールを見落とせば、大切な用件を逃します。不要なメールまで並べれば、結局は一般的なメールソフトと同じように、一通ずつ確認しなければなりません。だからこそ、私たちはこの判断の精度を最初に、最も厳しく検証しています。
この記事では、私たちの測定方法と結果をすべて紹介します。記事に出てくるすべての数値、各モデルがメール1通ごとに出した答え、そしてそれらを再計算するコードは、pingbo-benchで公開しています。
メールの分類は迷惑メール対策から始まりました
コンピューターが最初に任されたメールの仕事は、一部を捨てることでした。1997年、Microsoft Researchのチームがベイズ手法による迷惑メールフィルターの開発を始めました。1998年にはA Bayesian Approach to Filtering Junk E-Mailを発表しています。仕組みは単純です。各単語が迷惑メールと通常のメールに現れる頻度を数え、新着メールに含まれる単語ごとのオッズを掛け合わせます。「無料」「当選」があれば迷惑メールと判断しやすくなり、「会議」「議題」があれば通常のメールと判断しやすくなります。2002年にPaul Grahamが公開したA Plan for Spamは、自分のメールボックスを使って午後の数時間で学習させられる方法として、プログラマーの間に広まりました。
ただし、迷惑メールを送る側も検出される単語を避けるようになるため、単語を数えるだけでは防ぎきれません。Gmailは固定ルールから、データをもとに学習するモデルへと移行しました。2019年には、大規模なモデルで本文以外の情報も分析しています。送信者と送信元、本人確認の有無、数十億の受信トレイに届いた同じメールの扱われ方、利用者による迷惑メール報告などです。こうした仕組みで、Gmailは迷惑メールの99.9%以上を防いでいます。方法は変わっても、問いは同じです。このメールは迷惑メールでしょうか。
一方、フィルターを通ったメールの並び方は、ほとんど変わっていません。Gmail、Outlook、Yahooは、今もスレッドごとに会話を分け、新しいものを上に表示します。受信トレイが把握しているのは、開いたメールです。終わった仕事、返事を待っている相手、まだ済んでいない用件までは把握していません。ひとつの仕事が5つのスレッドにまたがり、3週間続けば、全体のつながりを覚えておくのは自分です。Pingboは、契約更新、採用、トラブル対応など、同じ仕事のスレッドをひとつの案件にまとめます。関係者、約束、期限、次の行動も一緒に記録し、仕事が終わるまで引き継ぎます。
Pingboが見極めるのは、その案件に対応が必要か、必要なら何をすべきかです。送信者が自分の言葉で何を求めているのか、次に動くのは誰なのかを読まなければ分かりません。「お願いします」「承認」という単語があっても、本人への依頼なのか、参考として転送されただけなのかは区別できません。言語モデルなら依頼の意味を読み取れます。ただ、自由に答えさせるだけでは、返ってくるのはひとつの見解です。製品で使うには、根拠を示せる判断にする必要があります。
判断が決まると、次の行動が決まります
判断の単位はメールではなく案件です。Pingboがスレッドを読む前に、Gmailが迷惑メールを取り除いています。Pingboは残った仕事を案件にまとめ、進行中の案件を2つのエリアに振り分けます。どちらへ置くかによって、その後の処理が決まります。
要対応には、まだ自分が対応すべき仕事だけが並び、カードに内容が示されます。要返信は、答えるべき質問があるメールです。開く前に返信の下書きが用意されているので、確認して送信するほか、書き直したり、先にPingboと相談したりできます。フォームの提出や請求書の承認など、返信以外の仕事には**要対応(返信以外の作業)**のカードが付きます。必要な手順もそこに書かれています。ボードを見る頃には、夜の間に進んだことが整理され、返信も準備されています。
待機中には、進行中でも今日は自分が動く必要のない案件が入ります。相手の返事を待っている場合もあれば、経過を見守るだけの場合もあります。Pingboはフォローアップが必要かを判断して日付を決め、その予定を守ります。期日になると、誰に何を確認すべきかを記したカードが再び表示されます。内容の根拠は、そのスレッドに残っている記録です。今すぐフォローを選ぶか、まだを選んで待つことができます。
案件を完了にすると、ボードから外れます。Pingboが行うのは、根拠となるメールを添えて完了を提案するところまでです。承認するかどうかは利用者が決めるので、勝手に閉じられることはありません。
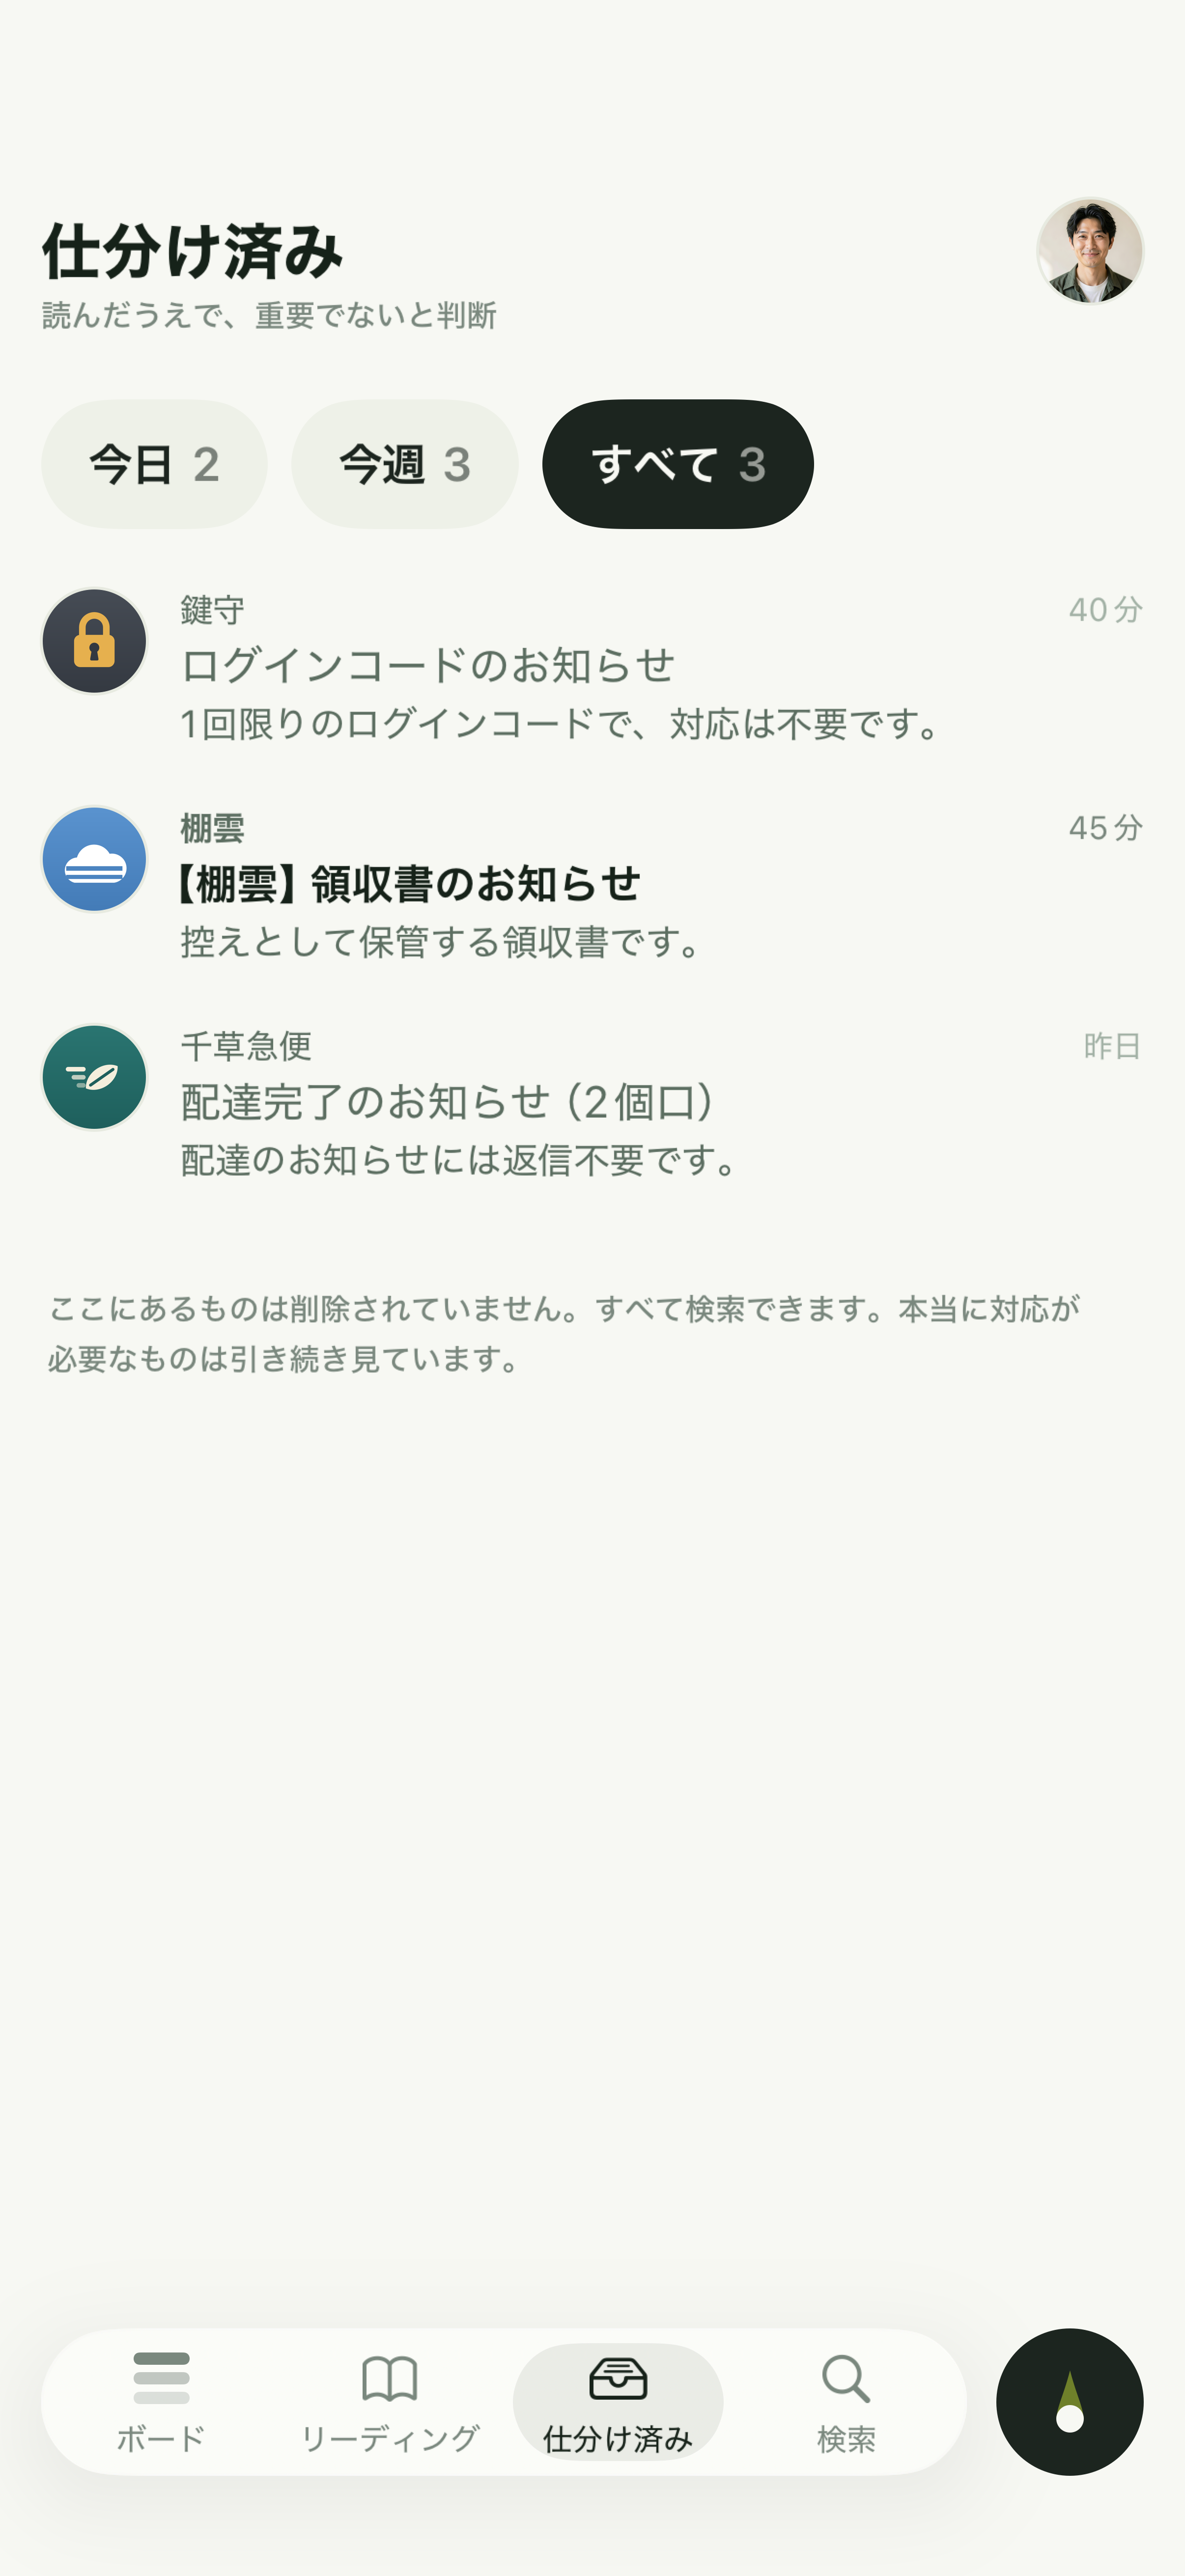
仕事につながらないメールにも置き場所があり、ボードには出てきません。仕分け済みには、一斉送信、自動通知、参考資料など、行動を求められていないメールが入ります。領収書や通知、読んでいないメーリングリストもここで保管され、削除されず、検索できます。リーディングは、ニュースレターや進捗報告、お知らせなど、目を通せばよいメールの置き場所です。
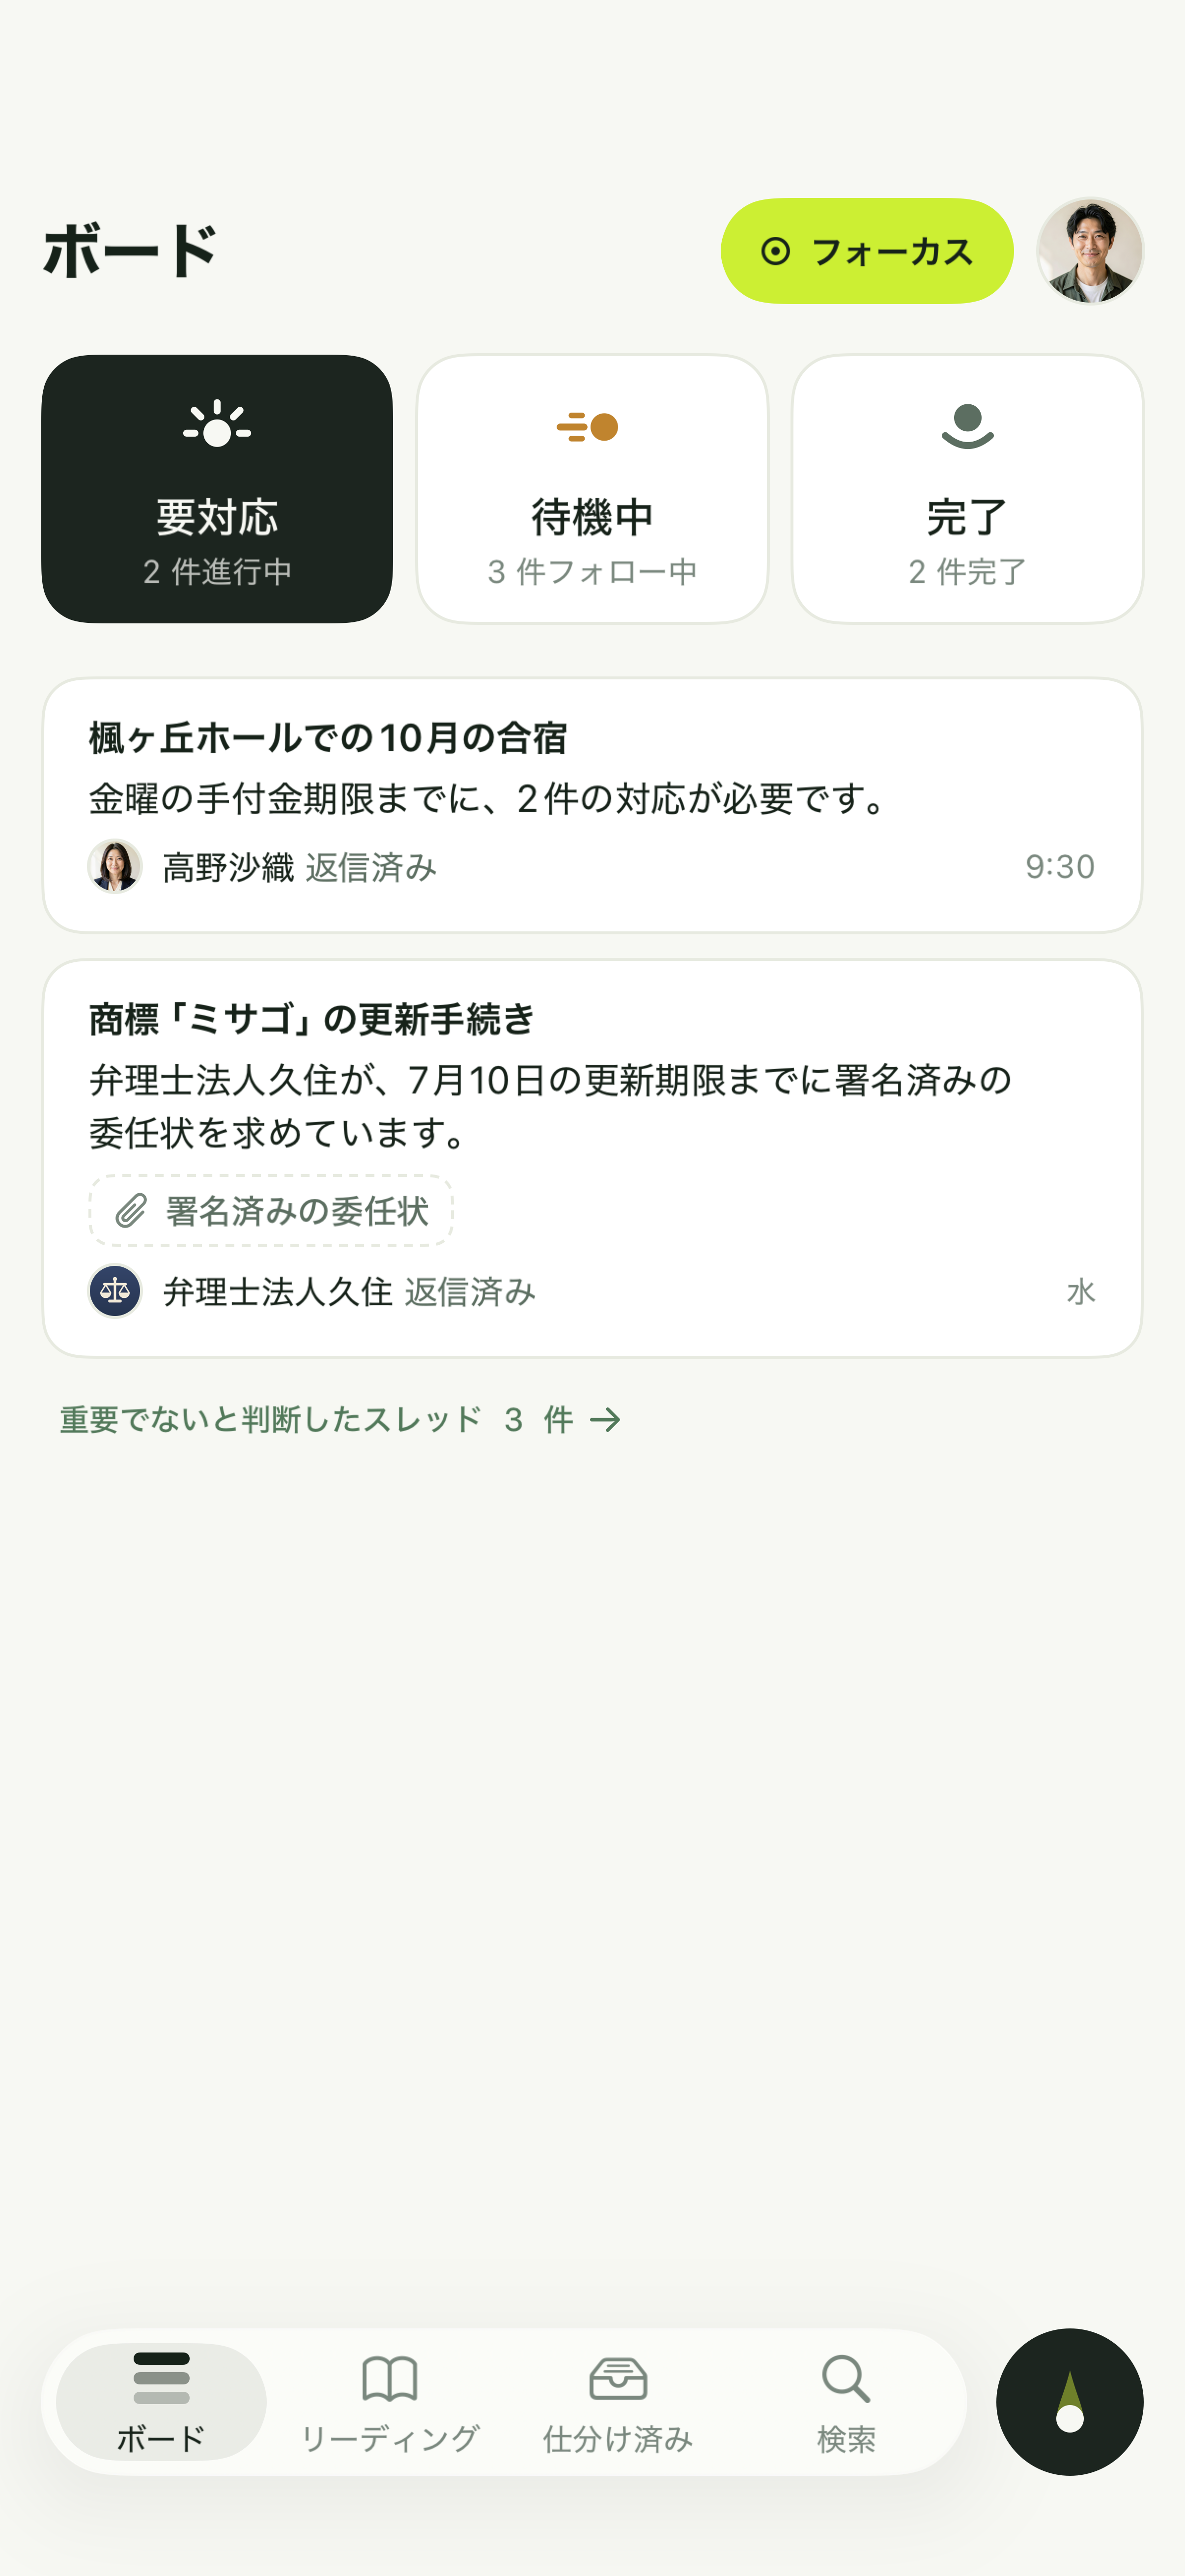
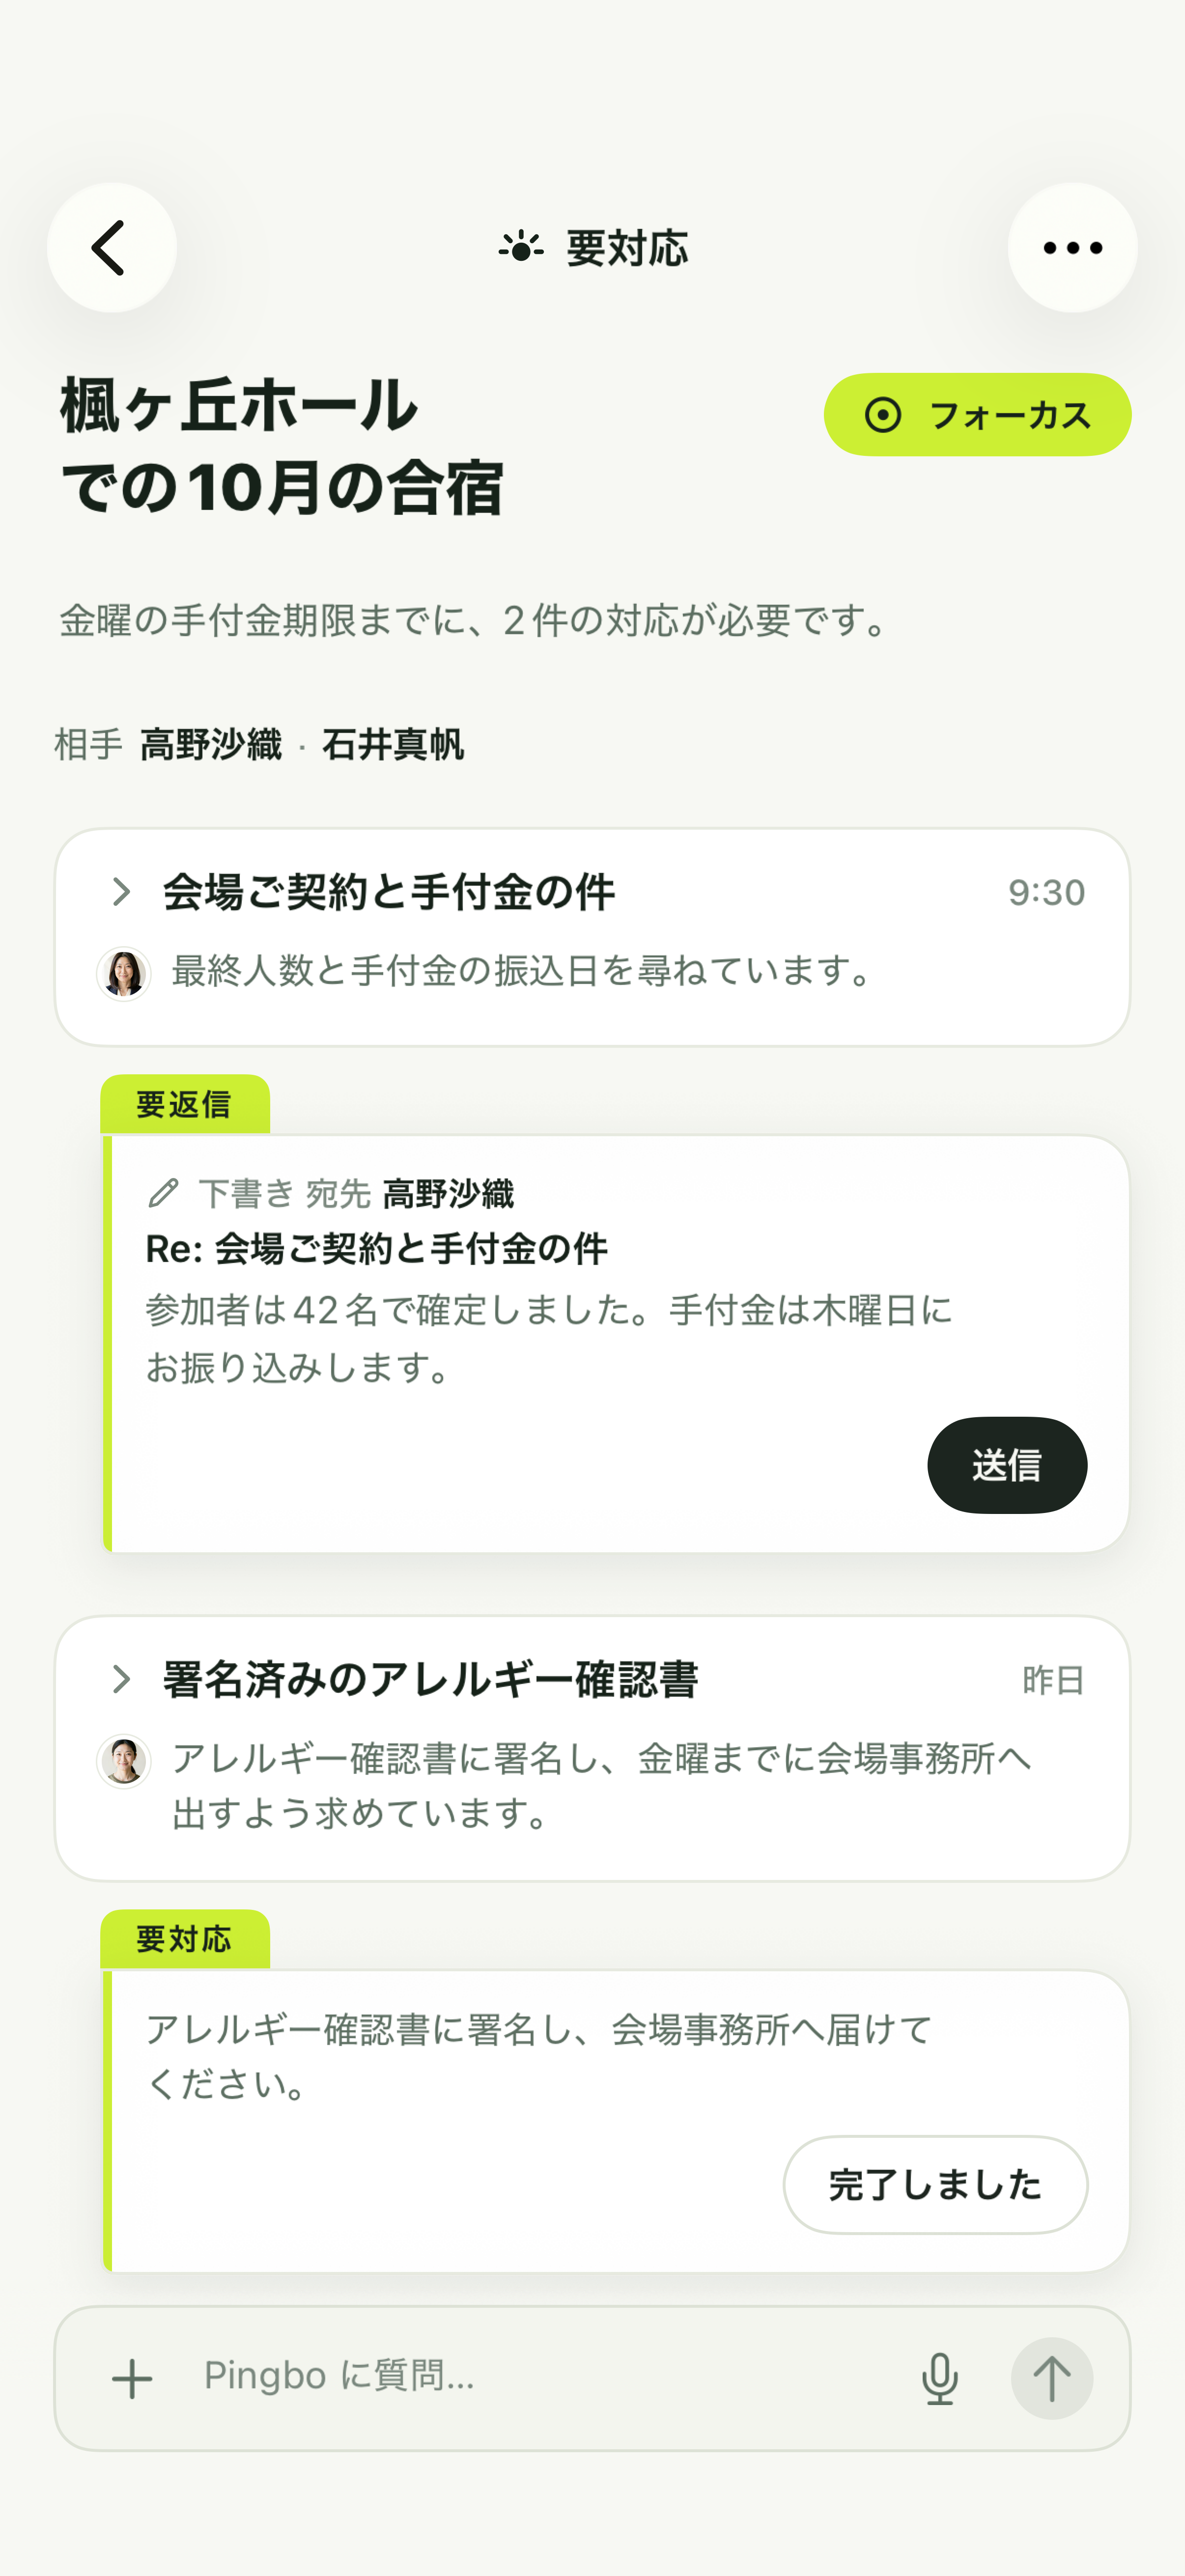
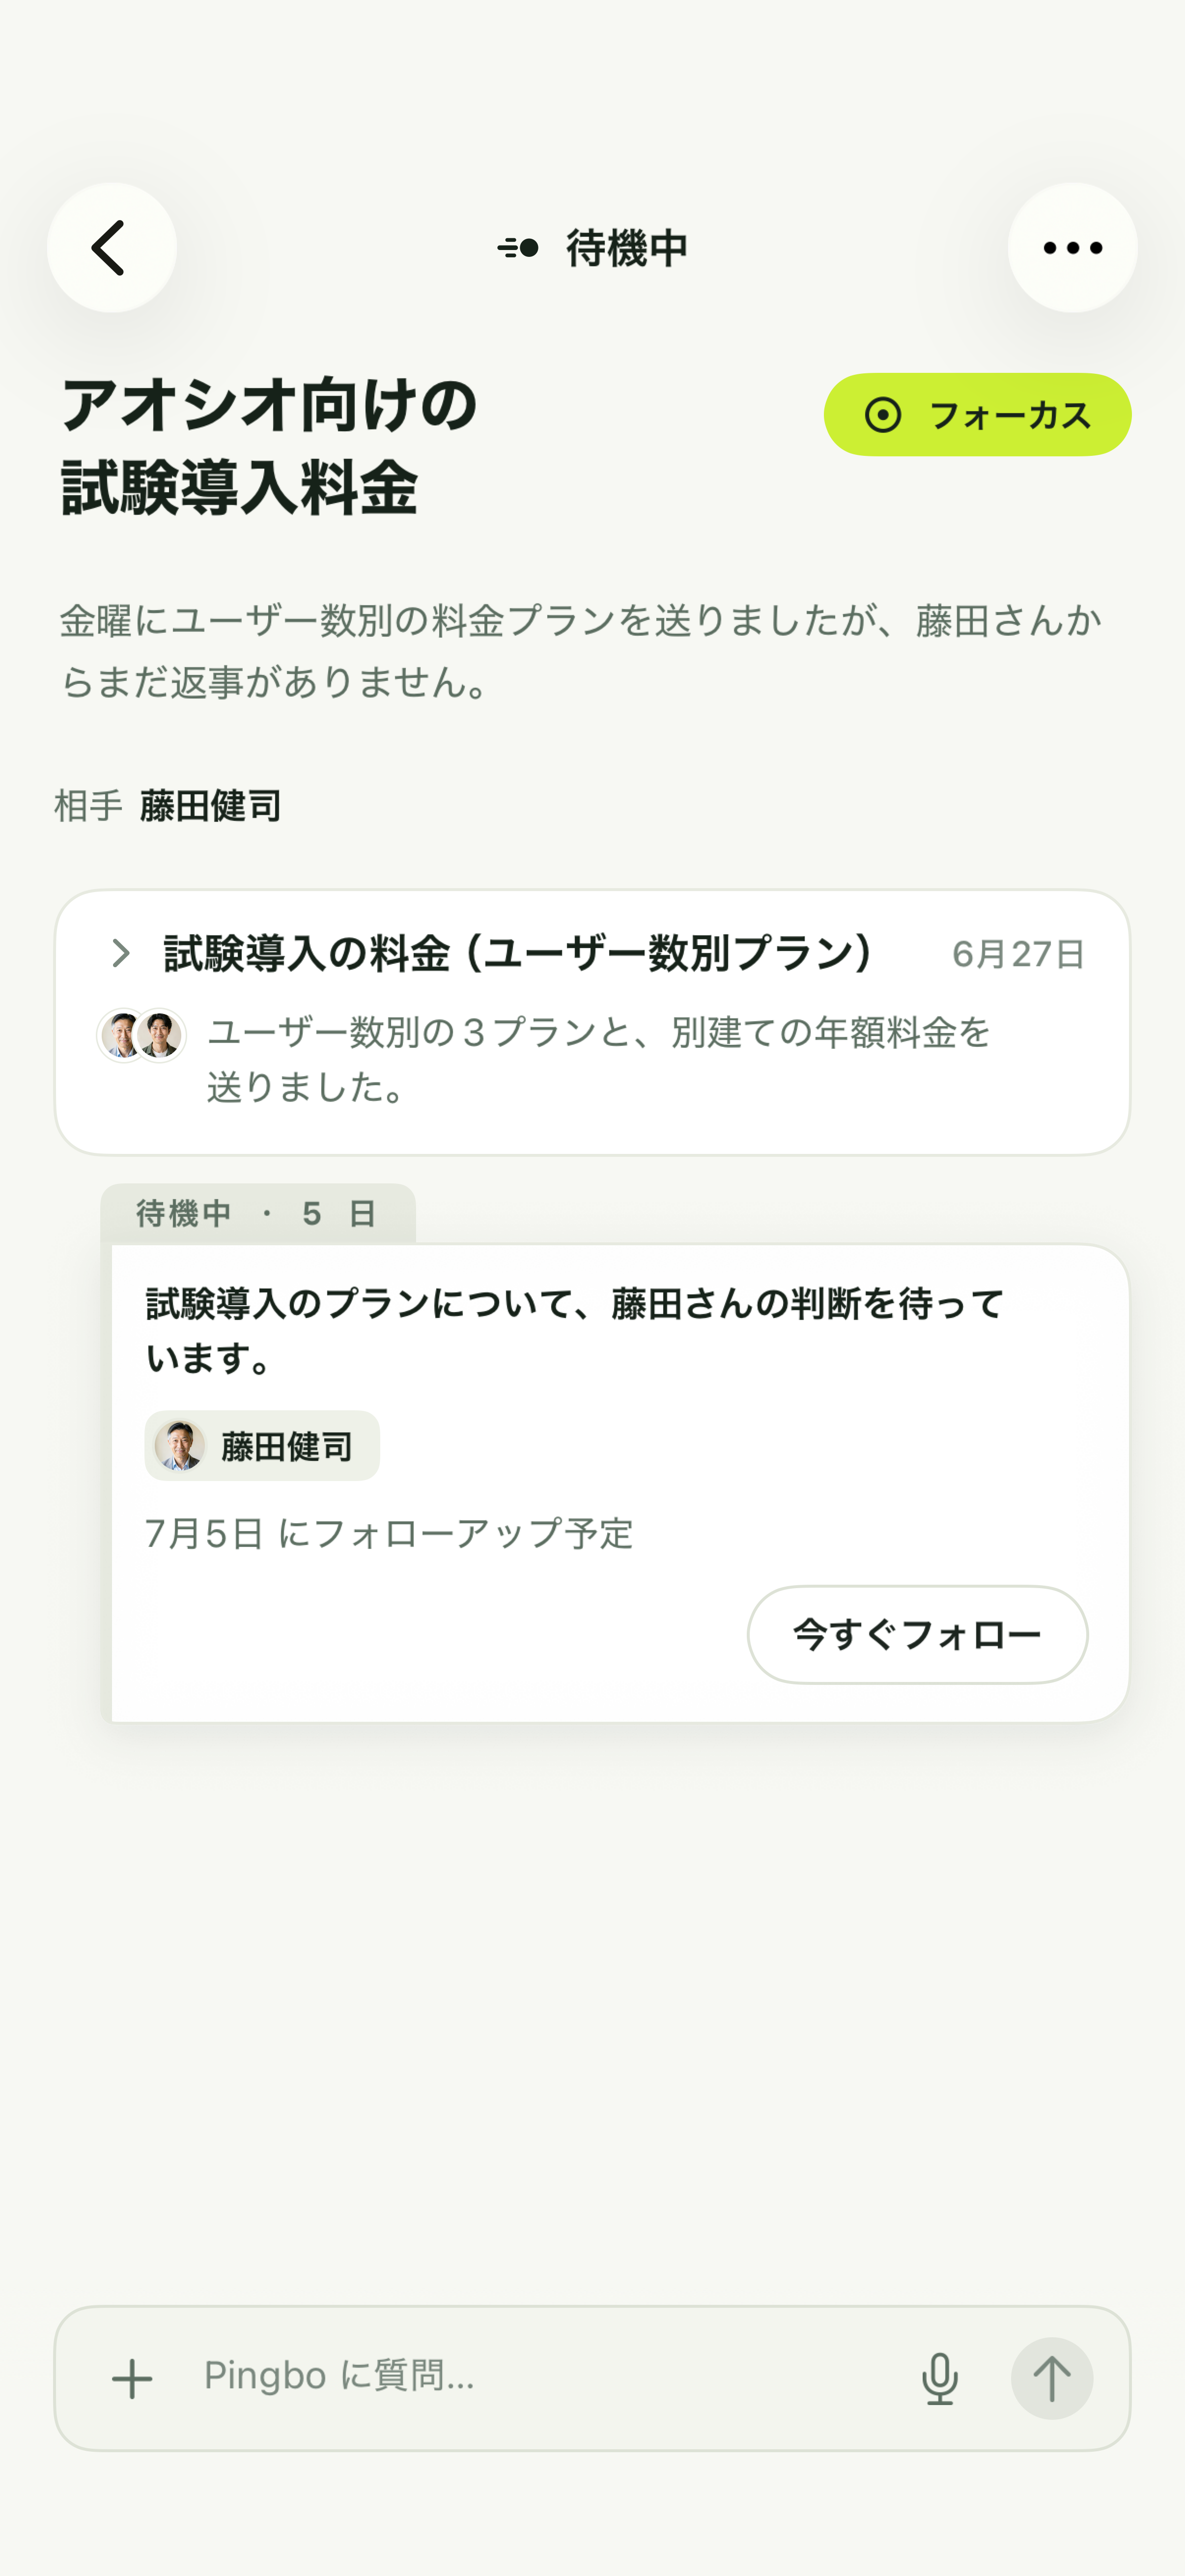
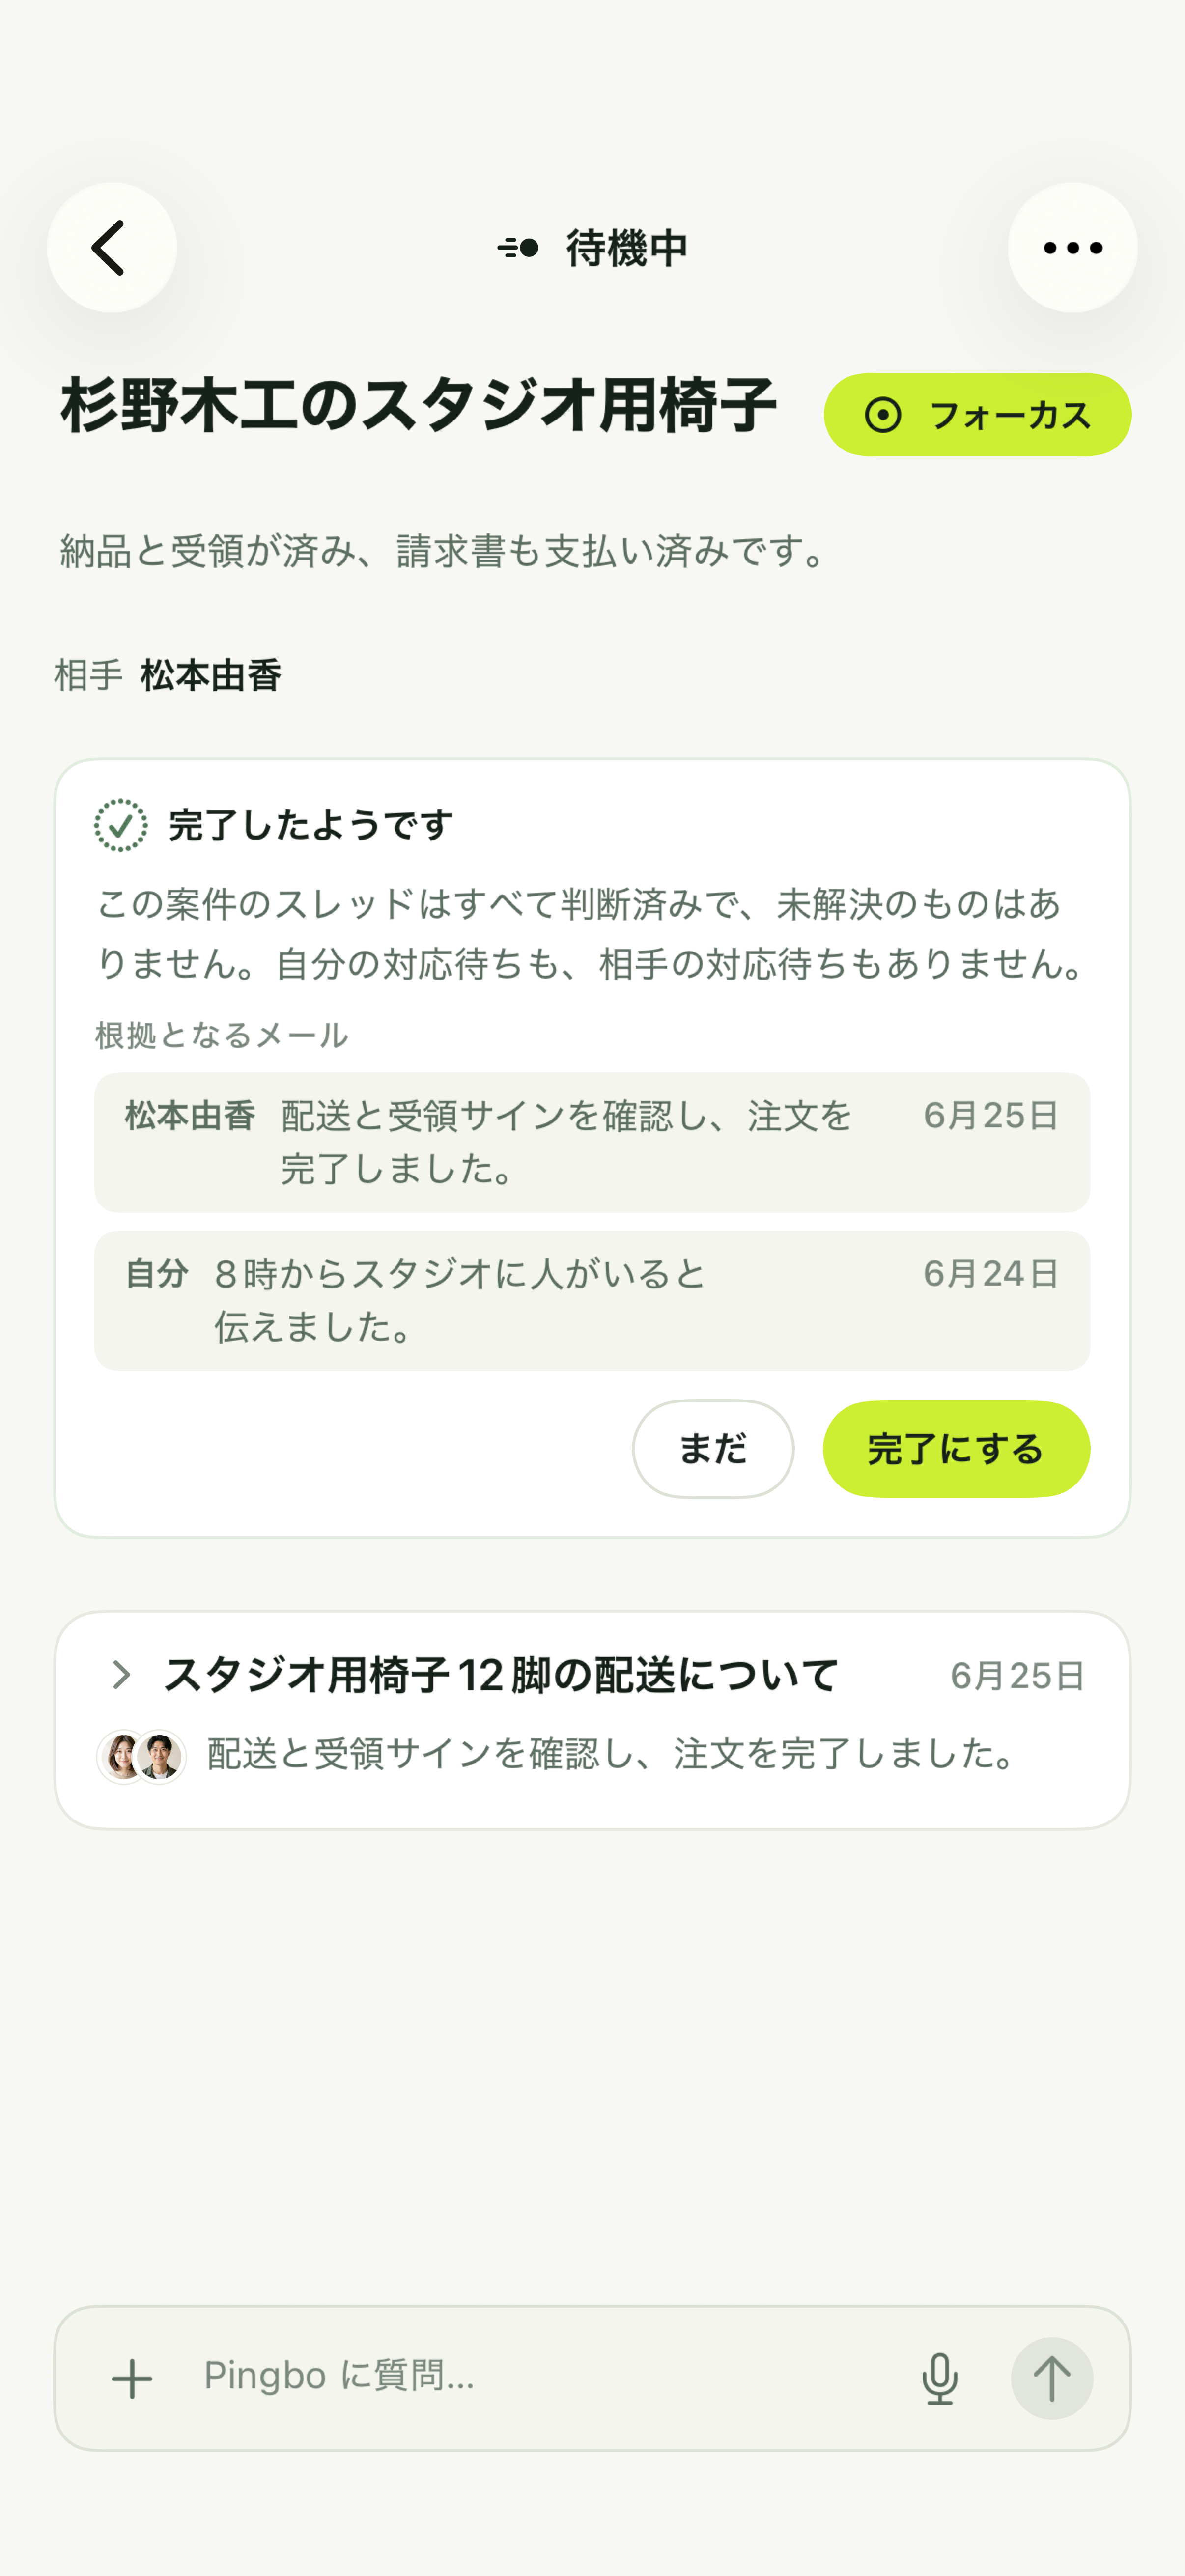
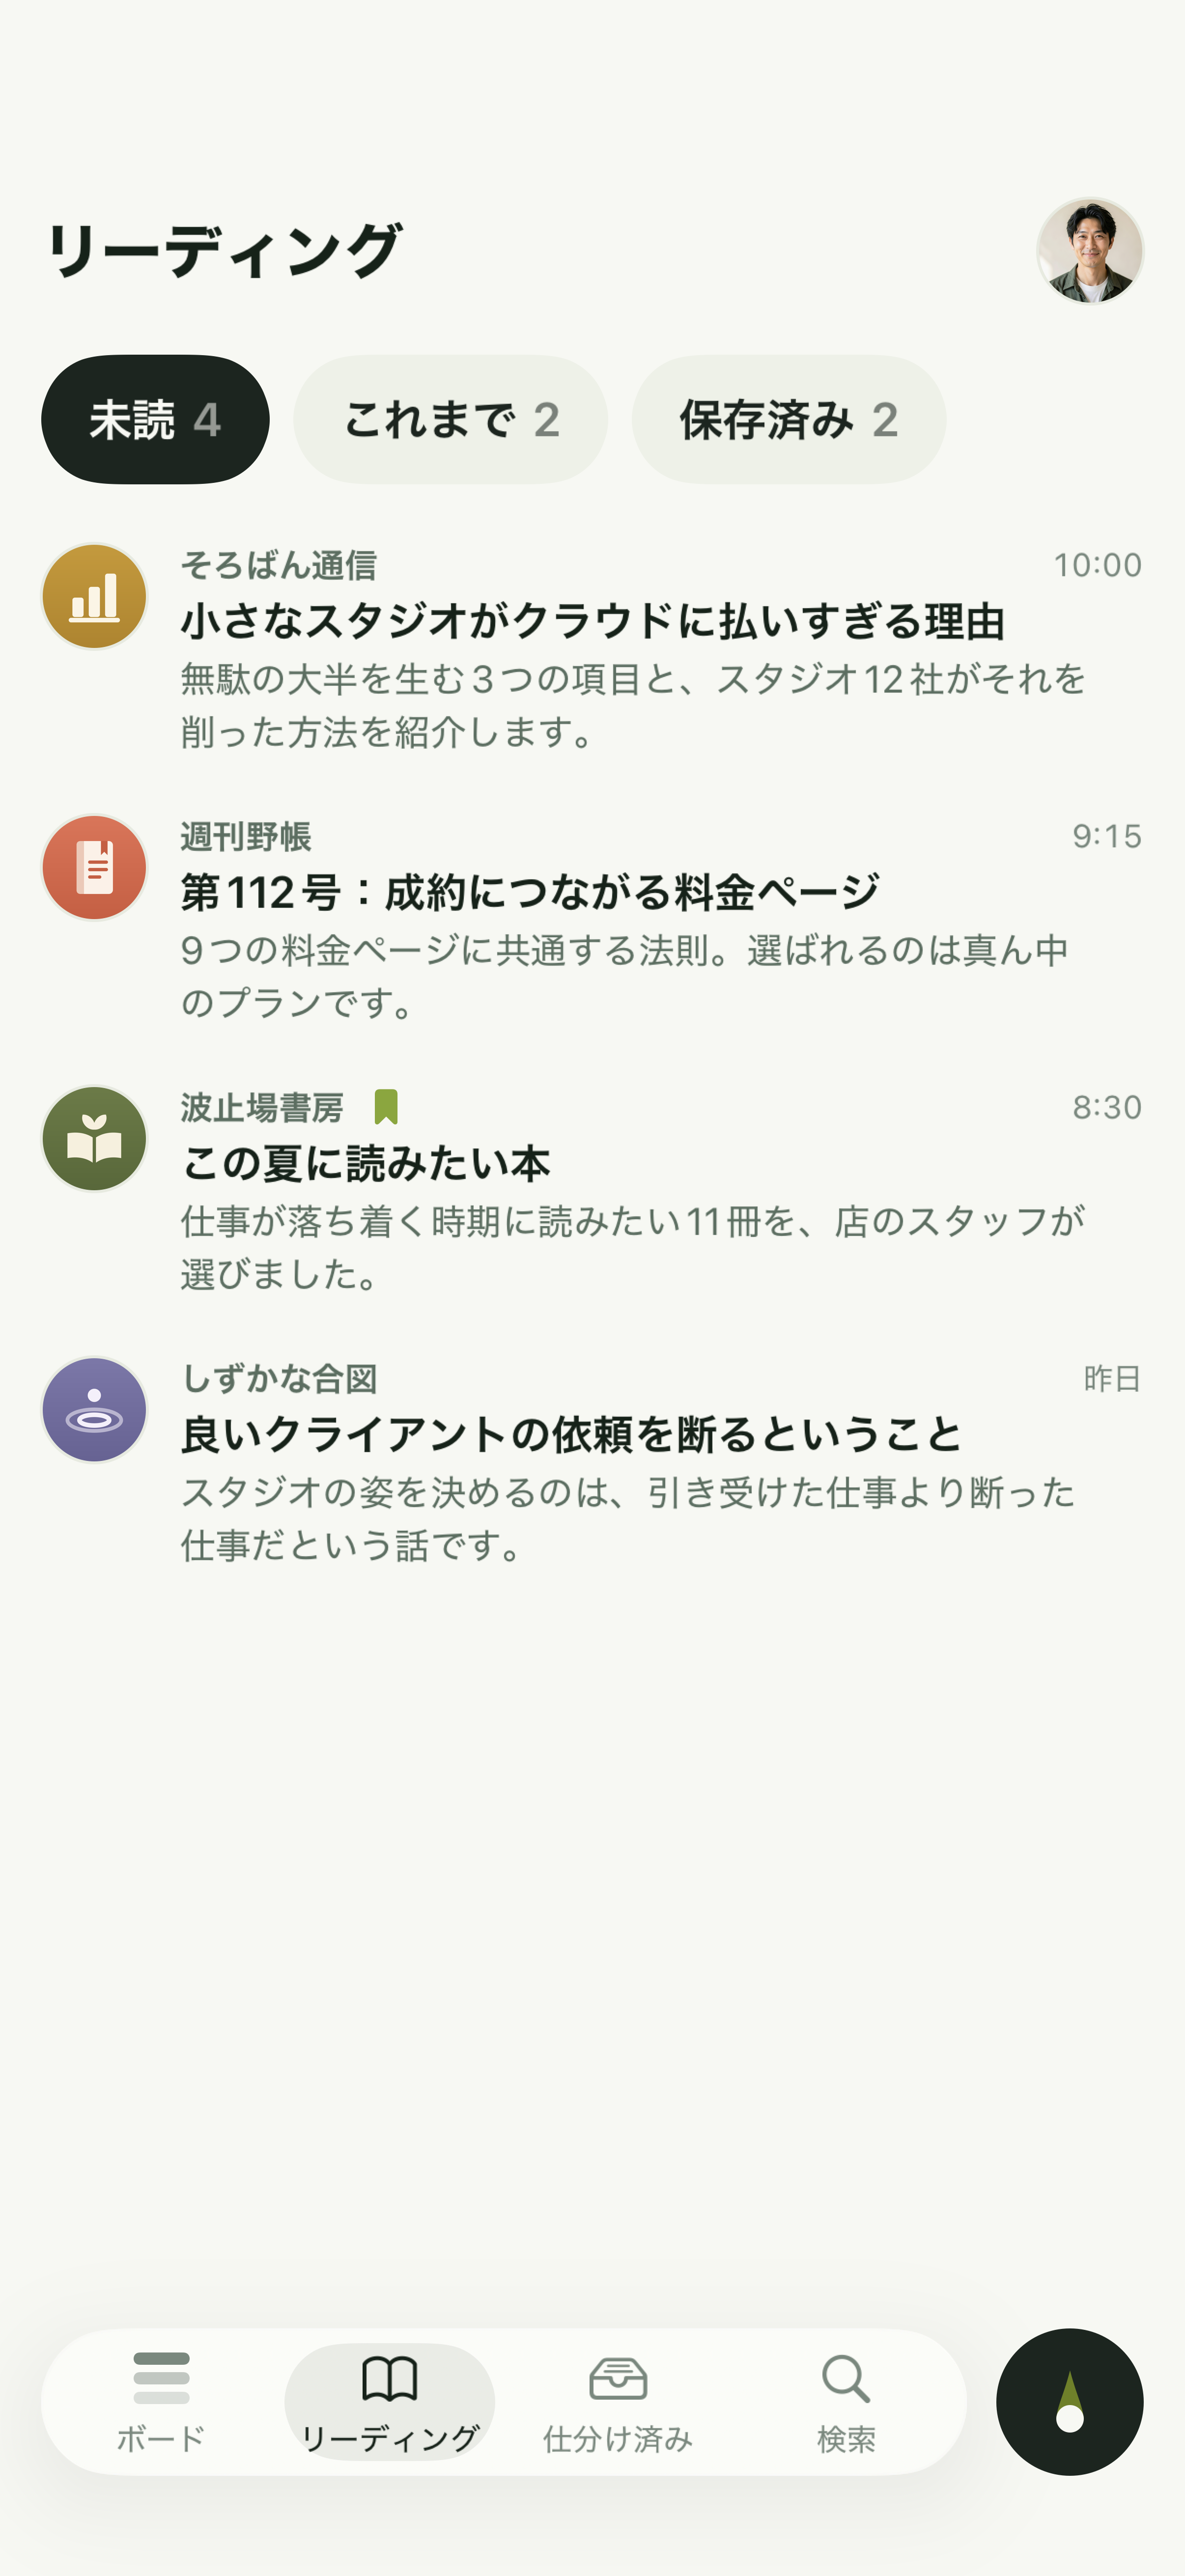
モデルには決まったフォームへ順番に回答してもらい、その答えをもとに判断します。ひとつの答えが、その後に選べる項目を決めます。まず次に動くのが自分か相手かを答え、そのうえで案件の置き場所を選びます。選択肢は、先ほどの4つです。返信が必要なら下書きを添えて要返信、別の作業が必要なら要対応(返信以外の作業)、相手待ちなら待機中です。会話が終わっていれば完了を提案し、利用者の承認を待ちます。返信が必要と判断する場合には、返信を求めている箇所をメールから引用しなければなりません。
こうして初めて、モデルの回答を案件の整理や下書きの作成、次の行動の準備に使えます。ただし、判断する項目が増えるほど、間違える箇所も増えます。単に「はい」「いいえ」と答える場合より難しいからこそ、モデルの言葉をそのまま信じず、実際の精度を測る必要がありました。
正しさをどう測るか
採点には、実際の業務メール508通を使っています。出典はSappelliほか(2016)、Information Sciencesの研究データで、本文はEnronのメールアーカイブと照合して取得しました。元の研究では、2人の評価者が1,145通を読み、それぞれ受信者に何が求められているかを記録しています。そのうち、両者の判断が一致した508通だけを採用しました。注意深く読んだ2人が合意できないメールを、ほかの回答を採点する基準にはできません。
元の分類は4つです。112通はすぐに返信が必要、67通は後で返信が必要でした。後者も返信は必要ですが、今日でなくても構いません。285通は把握しておく責任があるものの、返信は不要です。残る44通は無視してよいメールでした。Pingboが判断したいのは、どの案件があなたの注意を必要とするかです。そこで前の2つを要対応にまとめ、把握しておく責任があるメールは待機中に対応させました。無視してよいメールは、Pingboでは仕分け済みがボードの外にとどめます。この評価で採点するのは、返信が必要かどうかの1点だけです。したがって、112 + 67 = 179通が返信を必要とし、285 + 44 = 329通は返信不要です。
この比率が最低限の比較基準になります。508通すべてに「返信不要」と答えれば、329通は正解ですが、返信すべき179通はすべて見逃します。一文字も読まなくても、**329 ÷ 508 = 64.8%**の正解率になります。この数字を下回るなら、何もしない場合より悪い結果です。
正解率は全体でどれだけ当たったかを示しますが、間違いの内訳までは分かりません。2つのシステムが、どちらも508通中406通を正しく判定し、80%を記録する場合を考えます。片方は返信すべき179通のうち77通を見つけ、不要なメールは一通も表示しません。もう片方は160通を見つける代わりに、不要なメールを83通表示します。点数は同じでも、見逃したメールは102通と19通で大きく違います。そのため、結果は3つの指標で示します。正解率は全体の正しさ、再現率は返信すべきメールをどれだけ見つけたか、適合率は表示したメールのうち本当に返信が必要だった割合です。
この基準で評価するのは、3つの問いを確かめるために選んだ32のモデルです。OpenAIの16モデルとAnthropicの11モデルで、最先端のモデルがどこまでできるかを調べます。重みが公開されているQwen3.6は、自社のハードウェアで動かし、外部モデルを借りずに実現できる水準を確かめます。残る4つの小型モデルでは、この仕事をスマートフォンがどこまで担えるかを見ます。Gemmaと2種類のOrnithは、将来スマートフォンで動かせるほど小さなモデルです。Appleのオンデバイスモデルは、iOS 26とmacOS 26でApple Intelligenceを支えるモデルで、最近のiPhoneにはすでに搭載されています。Qwen3.6とこの4モデルの計5モデルは自社のマシンで動かしたため、図では「自社運用」にまとめています。32モデルすべてで、同じ508通を評価しました。
ただし、このデータセットはPingboのために作られたものではありません。そこで、数値を信頼する前にデータセット自体を確かめました。2人の評価者の判断が最も分かれたのは、4分類のラベルでした。一方、Pingboの採点に使う二択は、実際に返信があったかどうかとよく合っています。再評価した100通のうち24通では、3人目の読み手がデータセットと異なる判断をしました。評価方法を詳しく知りたい方は、末尾の付録をご覧ください。
単純なプロンプトから、製品のフレームワーク全体へ
Pingboでは、モデルを独自の実行フレームワークに組み込んでいます。先ほどのフォーム、回答の検証、結果を画面に出す前の処理をまとめた仕組みです。この仕組みでモデルの性能が上がることも、下がることもあります。そのため、変更のたびに同じ508通を32モデルすべてで再評価しました。ほかの条件は変えていないので、点数の変化はメールの違いではなく、私たちの変更によるものです。ただし、どの回の評価も実行は1回だけです。同じモデルでも実行のたびに答えは少しずつ変わるため、1通か2通の差に意味を読み取るべきではありません。図2が全体の記録です。
OpenAI 16
- gpt-5.6-luna
- gpt-5.6-sol
- gpt-5.6-terra
- gpt-5.5
- gpt-5.4
- gpt-5.4-mini
gpt-5.4-nano- gpt-5.2
- gpt-5.1
- gpt-5
- gpt-5-mini
gpt-5-nano- gpt-4.1
- gpt-4.1-mini
gpt-4.1-nano- gpt-4o-mini
Anthropic 11
- claude-opus-5
- claude-opus-4-8
- claude-opus-4-7
- claude-opus-4-6
- claude-opus-4-5-20251101
- claude-fable-5-1
- claude-fable-5
- claude-sonnet-5
- claude-sonnet-4-6
- claude-sonnet-4-5-20250929
- claude-haiku-4-5-20251001
自社運用 5
- qwen3.6-35b-a3b-mxfp4
- ornith-1.5-9b-mlx-full
ornith-1.5-9b-mlx-6bit- gemma-4-E4B-it-qat-4bit
apple-fm-on-device
ステップ0は、フレームワークをいっさい使わず、モデルにそのまま尋ねた結果です。各モデルはメールを1通読み、評価者が使った4分類の中から1つを選びます。その答えは、この記事のほかの数値と同じく、返信が必要という意味かどうかで採点しました。この方法での32モデルの中央値は77.0%で、半数がこれを上回りました。比較基準を超えたのは29モデルです。モデル単体でも、大部分の判断はできます。ただし、ラベルを1つ選ぶだけでは、誰に連絡すべきかも、返信の下書きも、ボード上の次の行動も用意できません。
ステップ1で初めてフォーム全体へ回答させると、成績は下がりました。すべての欄を埋めようとして、モデルが存在しない仕事を作り始めたためです。たとえば、同僚が改稿を送ってきただけで何も求めていないのに、「意見や承認を返信する」と提案します。中央値は65.0%まで下がり、比較基準を超えたのは17モデルだけでした。直接質問した場合と比べると、32モデル中28モデルがフレームワークによって悪化しました。問題は私たちが作った仕組みにありました。
ステップ2では、その点を修正しました。返信が必要と判断するなら、依頼文を引用させます。プログラムもメール本文を調べ、引用が実在するかを確認します。見つからなければ、返信が必要とは判定できません。中央値は81.3%に上がり、24モデルが比較基準を超えました。32モデル中23モデルが、フレームワークの中でも直接質問した場合と同等以上の成績になりました。過半数のモデルでフレームワークが役立ったのは、これが初めてです。
ステップ3のきっかけは、ステップ2で採用された引用を読み直したことです。5分の1は、新しいメールの本文ではなく、その下に付いている過去のやり取りからの引用でした。送信者が以前の質問に答えているのに、その古い質問を今こちらへ向けた依頼と誤解していたのです。結びの挨拶や、返信は不要でも作業が必要な引き継ぎも、返信の依頼として扱われていました。そこで、依頼は今回のメールで送信者本人が書いた言葉に限るという条件を加えました。中央値は82.5%、比較基準を超えたのは27モデル、最高は85.0%です。32モデル中25モデルが、フレームワークを使った方がよい成績になりました。
ステップ3は利用者にとって最も重要な変更ですが、図2では目立ちません。自社運用モデルの成績が6.3ポイント上がり、ほかのモデルとの差が7.9ポイントから2.8ポイントへ縮まりました。判断の品質は、モデルだけでなくPingbo自身の仕組みによっても高められます。基盤となるモデルを入れ替えても、この改善は残ります。その時々で最も強いモデルだけに頼る必要はありません。
ただし、代償もありました。その中身は、ひとつの数字から想像するものとは違います。同じモデルで、ルールを厳しくすると、返信すべきメールのうち要返信カードが付いた割合は68.2%から62.0%へ下がりました。その一方で、要返信カードのうち本当に返信が必要だったものの割合は61.6%から76.6%へ上がりました。要返信カードがなくなった19通のうち18通は要対応(返信以外の作業)のカードになり、一覧に残りました。その結果、返信すべきメールのうち待機中へ入ったのは13通から10通へ減りました。毎回3つの指標を測り直すのは、何が改善し、何を失ったかを確認するためです。すべてのモデルに有効なわけでもありません。32モデルのうち7つは、直接質問した方がよい結果でした。その多くは最も小さいモデルか、強く圧縮したモデルです。Pingboで使うモデルを価格だけでなく、コストと実測の性能を天秤にかけて選ぶ理由です。この限界が最もはっきり表れたのは、Appleのオンデバイスモデルです。直接質問すると70.1%で比較基準を上回りますが、フレームワークに組み込むと、どのステップでも比較基準を下回りました。ステップ3では、Pingboの指示と合わせて一度に読めるのが4,096トークン、英単語で約3,000語までで、508通のうち153通がこれに収まりません。残る355通のうち306通では、メールの置き場所について最初に下した判断がルールで却下されました。案件になったメールは1通もなく、返信の下書きもまったく作られませんでした。フレームワークがモデルを助けられるのは、まずモデルがフレームワークを扱いきれる場合だけです。
Pingboが採用しているのは、ステップ3の処理です。ここから先は手順を追加する話ではなく、この処理をどんな設定で使うかという選択になります。
メールを見逃すか、邪魔を減らすか
同じ処理でも、不要な表示を抑える設定と、必要なメールをできるだけ拾う設定があります。図3は、各モデルをそれぞれの設定で測った結果です。
OpenAI 16
- gpt-5.6-luna
- gpt-5.6-sol
- gpt-5.6-terra
- gpt-5.5
- gpt-5.4
- gpt-5.4-mini
gpt-5.4-nano- gpt-5.2
- gpt-5.1
- gpt-5
- gpt-5-mini
gpt-5-nano- gpt-4.1
- gpt-4.1-mini
gpt-4.1-nano- gpt-4o-mini
Anthropic 11
- claude-opus-5
- claude-opus-4-8
- claude-opus-4-7
- claude-opus-4-6
- claude-opus-4-5-20251101
- claude-fable-5-1
- claude-fable-5
- claude-sonnet-5
- claude-sonnet-4-6
- claude-sonnet-4-5-20250929
- claude-haiku-4-5-20251001
自社運用 5
- qwen3.6-35b-a3b-mxfp4
- ornith-1.5-9b-mlx-full
ornith-1.5-9b-mlx-6bit- gemma-4-E4B-it-qat-4bit
apple-fm-on-device
| 要対応に含めるカード | 返信が必要な179通のうち見つけた数 | 表示したメールのうち返信が必要な割合 | 表示したメール数 |
|---|---|---|---|
| 要返信のみ | 119(66%) | 89% | 133 |
| 返信以外の作業も追加:Pingboの初期設定 | 150(84%) | 62% | 241 |
| さらに独立した判断を追加 | 159(89%) | 60% | 265 |
表1。実測で最もよかったgpt-5.5で、要対応を3通りに構成した結果です。どの行もステップ3の処理を使い、設定だけを変えています。最後の行は最も多くの返信すべきメールを見つけますが、受信トレイの半分以上を表示します。
表1の1行目は要返信カードだけです。2行目は返信以外の作業も加えたもので、これがPingboの初期設定です。3行目では、各案件をもう一度読み、最初の結果とは独立して判断します。
評価者が記録したのは、メールに返信が必要かどうかです。要対応はそれより広く、別の作業を求めるメールも含みますが、データセットにはその区別がありません。2行目は241通、1行目は133通で、表示が108通増えています。そのうち31通を、2人の評価者とも返信すべきメールと判断していました。そのため、見つけた数も119通から150通へ増えます。残りの77通は、採点上の誤りになります。ただし、それだけで表示すべきでなかったとは言えません。「作業が必要」というラベルがないためです。本来要対応に入るべき仕事も、実際の誤判定も含まれますが、記録からは分けられないので、どちらとも断定しません。適合率が89%から62%へ下がるのは、この77通が加わるためです。
Pingboが一覧に出さなかったメールについても測定します。表1の中央、初期設定では、gpt-5.5は241通を表示するので、残る267通は要対応に入りません。返信すべき179通のうち150通を見つけているので、29通は返信が必要なのに一覧から漏れました。残る238通は、返信不要とラベル付けされていたメールです。課題は、この29通を減らすことです。
この267通は、ひとつの置き場所にまとまっているわけではありません。ラベルも、これらのメールに何も必要なかったと示すものではありません。Pingboはこのうち46通を待機中、124通を完了に振り分けています。95通はそもそも案件にならず、リーディングか仕分け済みに入りました。残る2通は、モデルの呼び出しが失敗したものです。評価者が記録したのは返信が必要かどうかだけなので、そのメールがまだ何かを求めていたかどうかは、ここの数値からは分かりません。
このモデルと設定の組み合わせでは、見逃しと不要な表示を同時に最小にする方法はありません。必要なメールを多く見つけようとすれば、不要なメールも多く表示します。どこで折り合いをつけるかは、数字だけでは決まりません。ただし、これは避けられない法則ではありません。32モデルのうち5つは、もう一度読み直す処理を加えると、両方の指標が良くなります。claude-opus-5もそのひとつです。読み直しがそれまでの処理で取りこぼしていたメールを拾う一方、一覧はそれほど広がらないためです。そして、2つの間違いがもたらす負担も異なります。必要なメールを見逃すと、相手は返事を待ち続け、こちらはそのことにすら気づかない場合があります。不要なメールが一通出るだけなら、確認に一秒ほどかかる程度です。
現在のPingboができること
今回の評価では、Pingboが返信すべきメールを何通見つけ、何通を要対応に載せられなかったかを調べました。508通のメールから、多くの人に合う基準は探せても、利用者一人ひとりに何が合うかまでは分かりません。たとえば、スタートアップの創業者は、投資家からの返信なら、どれほど短くても見逃したくないかもしれません。一方、一日中CCのメールが届く会社の管理職は、自分の対応が必要な少数のメールだけを見たいかもしれません。同じ基準では、両方の要望を満たせません。
付録で詳しく述べるとおり、データセットにも限界があります。返信の要否という単純な問いでも、2人の評価者の一致率は70%でした。一定の水準を超えると、点数を上げても、単にラベルへ合わせただけという結果になってしまいます。Pingboが使いやすくなったとは限りません。実際のメールのやり取りは、さらに複雑なことが多いです。スレッドは長くなり、関係者も増え、依頼が転送文の中に埋もれます。目指しているのは、使う人にとって99.99%正しく判断できるPingboです。データセットをどれほど慎重に検証し、新たなデータセットをいくら集めても、標準的なデータセットだけではこの目標に届きません。
自分のメールをどう扱うべきかを知っているのは、利用者本人です。Pingboは一人ひとりの基準を学び、使いながら調整し続ける仕組みを備えます。初期設定でいくつか質問し、その後は操作から学びます。要対応に載らなかったメールへ返信すれば、そのメールの振り分け先がどこであっても、Pingboが読み取れる手がかりになります。ただし、判断が誤っていた証拠ではありません。返信が必要とは限らないからです。返信しないまま要対応から外したメールも、同じく手がかりのひとつです。確かさの度合いも変わりません。求められていた用件を、メール以外の方法で済ませている場合もあるからです。こうした手がかりを重ね、時間をかけて読み取ることで、基準は少しずつ動いていきます。その結果、表1の取捨選択は、全員共通の設定から、その人に合わせて変わり続ける判断になります。
Pingboは、使う人が何を重視するかを学び続けるエージェントです。対応が必要だと伝えるときには、誰が何を求めているか、なぜ対応が必要かを送信者の言葉で示し、返信の文面もあらかじめ用意します。今すぐ対応しなくてよいと伝えたものは、安心して後回しにできます。そうすれば、本当に注意を向けるべきことに、時間と力を注げます。
付録:この評価はどこまで信頼できるか
Sappelliほかのデータセットは、Pingboのために作られたものではありません。メールを4つに分類していますが、Pingboが判断するのは、メールを要対応と待機中のどちらに入れるかです。この記事の数値はすべてこのデータセットが基準です。そのため、Pingboの評価で使うより先に、2つのことを確かめました。4分類のラベルをどこまで信頼できるか、そしてPingboの採点に使う二択がそれと比べてどうかです。2人の答えが一致していても、正しいとは限りません。元の4分類で2人が合意できたのは、1,145通中508通、44%だけでした。判断が分かれたメールでは、3人目の読み手も、その4分類にはおおむね同意しませんでした。二択では同じ2人の答えがはるかに多く一致し、そのラベルは実際に返信があったかどうかともよく合っています。どちらの確認も、個々のメールについてどの答えが正しいかを決めるものではありません。以下では、どう確かめたかを説明します。
気になったのは、初期段階でのモデルの間違い方でした。32モデルに元の4分類で508通を仕分けさせました。データセットの答えに最も近い8モデルを2つずつ比べると、答えの一致率は平均78%でした。ところが、各モデルとデータセットの答えとの一致率は、平均63%にとどまります。能力不足なら間違い方はもっとばらつき、他モデルとも評価者とも、同じくらい食い違うはずです。実際には、8モデルが何度も同じ答えにたどり着き、評価者がそれを不正解としていました。モデルの答えが一致しても、正しい証拠にはなりません。同じ間違いを共有していることもあるからです。それでも、これらのラベルを読み直す理由としては十分でした。
そこで、8モデルすべてがデータセットと異なる答えを出した57通を、出所を伏せて再評価しました。比較のため、もともと答えが一致していた43通も混ぜています。採点役も32モデルのうちのひとつです。この43通は、採点役が無作為に答えたのではなく、渡された採点シートを読んで判断したことを示します。ただし、この43通ではモデルとデータセットの答えが同じなので、採点役が単にモデル側に付いていなかったことまでは示せません。100通すべての採点が終わるまで、どの答えを誰が出したかは明かしませんでした。図A1に結果を示します。
意見が分かれたメールでは、採点役は45通でモデルの答えを、5通でデータセットの答えを選び、7通ではどちらも選びませんでした。もともと一致していた43通では、すべてデータセットと同じ判断でした。公平なコインを50回投げて、45対5かそれ以上に偏るのは、約2億4,000万回に1回です。統計では、このような確率をp値と呼びます。今回の二項検定では4.2e-9となり、よく使われる基準の0.05を大きく下回りました。ただし、注意点が2つあります。ひとつは、この57通が最も意見の分かれた例であり、無作為に選んだ標本ではないことです。ここから分かるのは、モデルとデータセットの判断が最も食い違う箇所です。それ以外の部分でどちらがどれだけ間違えるかも、どちらの判断が正しいかも分かりません。もうひとつは、採点シートが長いメールを4,000文字で打ち切ることです。100通のうち6通がこれに当たり、その6通で採点役が読んだ範囲はモデルより狭くなっています。
データセット全体が使えないわけではありません。問題は、4つの選択肢では評価者自身も合意しにくかったことです。2人とも分類を付けたのは1,145通のうち1,115通で、そのうち607通で判断が分かれました。138通は2人とも返信が必要だと考え、今すぐか後でよいかだけが違っていました。134通では、返信不要という点は同じで、読む必要があるかどうかだけが違っていました。この272通は、分類先が違っていても、返信の要否では一致しています。返信が必要かどうかの二択にすると、同じ2人は1,115通中780通、70%で一致します。
とはいえ、2人の意見が一致しても、正しいとは限りません。そこで二択のラベルを、評価者が書いたものではない事実と照らし合わせました。受信者が実際に返信したかどうかです。Enronのアーカイブには、各メールの後にやり取りされたメールも残っています。受信者の誰かが30日以内に送ったメールのうち、件名が同じものや元のメールを引用したものを返信とみなしました。これは大まかな判定です。アーカイブには返信のつながりが記録されていないため、受信者がメールを別の相手へ転送した場合も返信に数えてしまいます。見つかった115件の返信のうち72件は、件名の一致だけを根拠にしています。また、受信者自身の送信済みメールがアーカイブに入っていなければ、返信したかどうかは分かりません。その場合、返信が見当たらなくても証拠にはなりません。このため、まずはアーカイブの社員名簿に受信者が載っている209通を数えました。
ラベルが実際の返信と無関係なら、返信が必要とされたメールとそうでないメールは、同じくらいの割合で返信を受けるはずです。その場合、2つの割合の差はゼロに近くなります。実際には、データセットで返信が必要とされたメールは51.8%が返信を受け、それ以外は24.8%で、差は26.9ポイントでした。この差は限られた数のメールから推定した値なので、95%信頼区間で幅を示すと12.3から42.1ポイントです。下限でもゼロを上回ります。アーカイブで一度でもメールを送った受信者まで含めると491通になり、差は14.3ポイントに縮みます。信頼区間は6.2から22.4ポイントで、下限もゼロを上回ります。つまり、返信が必要とラベル付けされたメールは、実際に返信を受けることが多かったのです。これはデータセット全体で見たときの関連であり、一通ごとのラベルが正しい証拠ではありません。
3つ目の数え方として、返信が確認できたメールをすべて加えると257通になり、差は33.6ポイントまで広がります。この数え方を最後に挙げるのは、対象の選び方自体に、確かめたい答えが一部入り込んでいるためです。同じメールで比べると、8モデルの多数決による答えでは差が小さくなります。209通では14.8ポイント、257通では23.0ポイント、491通すべてでは5.5ポイントです。信頼区間が重なっているだけでは、どちらの差が大きいかは決まりません。そこで、データセットの差とモデルの差を、メール1通ずつ突き合わせて比べました。3つの数え方のいずれでも、差が大きいのはデータセットの方でした。その開きは209通で12.1ポイント、257通で10.6ポイント、491通すべてで8.8ポイントです。どの開きも、信頼区間の下限がゼロを上回ります。491通すべてでは3.0から14.7ポイント、209通では0.6から24.2ポイント、257通では0.3から21.2ポイントです。後の2つは、下限がゼロをかろうじて上回る程度です。また、関連があることと、毎回正しいことは違います。ラベルは送信者が返事を期待していたことを記録したものですが、受信者は忙しくて返信しないこともあります。返信のないメールがあっても、そのラベルが間違っているとは限りません。
二択のラベルも完全ではありません。再評価した100通のうち24通は、採点役の答えを採ると、返信が必要かどうかまで変わります。同じメールが複数の行に現れることがあるため、この24通は採点対象の508行のうち26行、その5.1%にあたります。これは疑わしいと分かったメールの数であって、誤ったラベルがどれだけあるかの推定値ではありません。この100通は意見の分かれたメールを選んだものであり、採点役もモデルのひとつで、残る395通は読み直していないからです。ここから言えるのは、このデータセットで最上位に近い点数を正確な値として読むべきではない、ということだけです。
では、このデータセットは、測定の物差しとして使えるのでしょうか。元の4分類については、使えません。この記事の採点も、そのラベルでは行っていません。2人の評価者がこの4分類で合意できたのは、44%だけでした。意見が最も分かれたメールでは、3人目の読み手が45対5でモデルの答えを選んでいます。一方、この記事の数値はすべて、返信が必要かどうかという二択が基準です。こちらは、確認の結果が逆でした。同じ2人の一致率は70%です。このラベルは、受信者が実際に返信したかどうかとも合っています。返信を確認できる受信者の数え方3通りのいずれでも、結果は同じでした。しかも、その結びつきは8モデルの多数決による答えよりも強く出ています。採点に使うラベルとして重要なのは、この比較です。モデルと変わらない精度のラベルでは、モデルを採点できないからです。
もっとも、これで個々のラベルが正しいと決まるわけではありません。ここでの確認では、そこまでは確かめられません。どれも間接的な確認であり、読み直した100通は判断が最も食い違うメールばかりで、残る395通は一度も読み直していないからです。それでも、このデータセットは測定に使える程度には信頼できます。ただし、区別できるのはメール1通の差ではなく、数通の差です。採点対象の508行のうち26行が疑わしい以上、1通や2通の差で他のモデルを上回っていても、上回ったことにはなりません。この記事の数値は、すべてこの基準に照らして読んでください。