
Pingbo 如何判断哪些邮件需要你处理
Pingbo 会学习什么对你重要,把已处理的事、还在等待的事,以及需要你接手的事整理清楚。你可以有空的时候再来看,不必随时被新邮件打扰。
Pingbo 的任务很明确:找出收件箱里真正重要的邮件,其余的先放在一边。说起来简单,做好却不容易。
Pingbo 其他的功能都建立在这个判断之上。对方确实需要你回复,提前写好的草稿才有用;你确实在等对方,安排跟进才有意义。漏掉该提醒的邮件,你就可能错过重要的事;把不需要处理的邮件也列出来,你又得逐封确认,和一般的收件箱软件没什么区别。因此,我们最先测试、也最严格审视的,就是这个判断能有多准。
这篇文章分享了我们的测试方法和完整结果。文中的每个数字、每个模型对每封邮件给出的答案,以及重新计算这些结果的代码,都公开在 pingbo-bench。
邮件分类不是新问题
人们最早教计算机处理邮件,做的就是把其中一部分丢掉。1997 年,Microsoft Research 的一个团队开始用贝叶斯方法开发垃圾邮件过滤器,并在 1998 年发表了 A Bayesian Approach to Filtering Junk E-Mail。原理并不复杂:先统计每个词在垃圾邮件和正常邮件中出现的频率,再把新邮件里各个词对应的几率相乘。“免费”“中奖”会让邮件更可能被判为垃圾邮件,“会议”“议程”则相反。2002 年,Paul Graham 在 A Plan for Spam 中给出了一套程序员用自己的邮箱、花一个下午就能训练的方法,随后广泛流传。
但垃圾邮件的发送者也会调整用词,单靠词频统计很快就不够了。Gmail 逐渐从固定规则转向能从数据中学习的模型。到 2019 年,它已经用大型模型分析正文之外的线索:发件人是谁、从哪里发来、身份是否经过验证、同一封邮件在数十亿个收件箱中的表现,以及用户把哪些邮件标为垃圾邮件。Gmail 靠这些方法拦截了超过 99.9% 的垃圾邮件。方法一直在变,要回答的问题始终相同:这封邮件是不是垃圾邮件?
过滤之后,收件箱的组织方式却没怎么变。Gmail、Outlook 和 Yahoo 仍然把每个会话单独列出,最新的排在最上面。收件箱知道你打开过哪些邮件,却不知道你处理完了什么、正在等谁,以及还有什么没做。一项工作如果横跨五个会话、持续三周,你仍得自己记住它们之间的联系。Pingbo 用事项来组织工作:续约、招聘、争议处理,同一件事的所有会话都放在一起,连同相关人员、承诺、截止日期和下一步,持续保留到事情结束。
Pingbo 需要判断的是:这件事是否需要你处理?如果需要,该做什么?这得看发件人亲自提出了什么要求,以及现在轮到谁采取行动,光数词语无法判断。过滤器即使识别出“请”和“批准”,也分不清对方是在请你批准,还是只是转发给你参考。语言模型能读懂这层意思,但如果让它自由回答,得到的往往只是一段看法。要用在产品里,还得形成有明确依据的判断。
关键判断
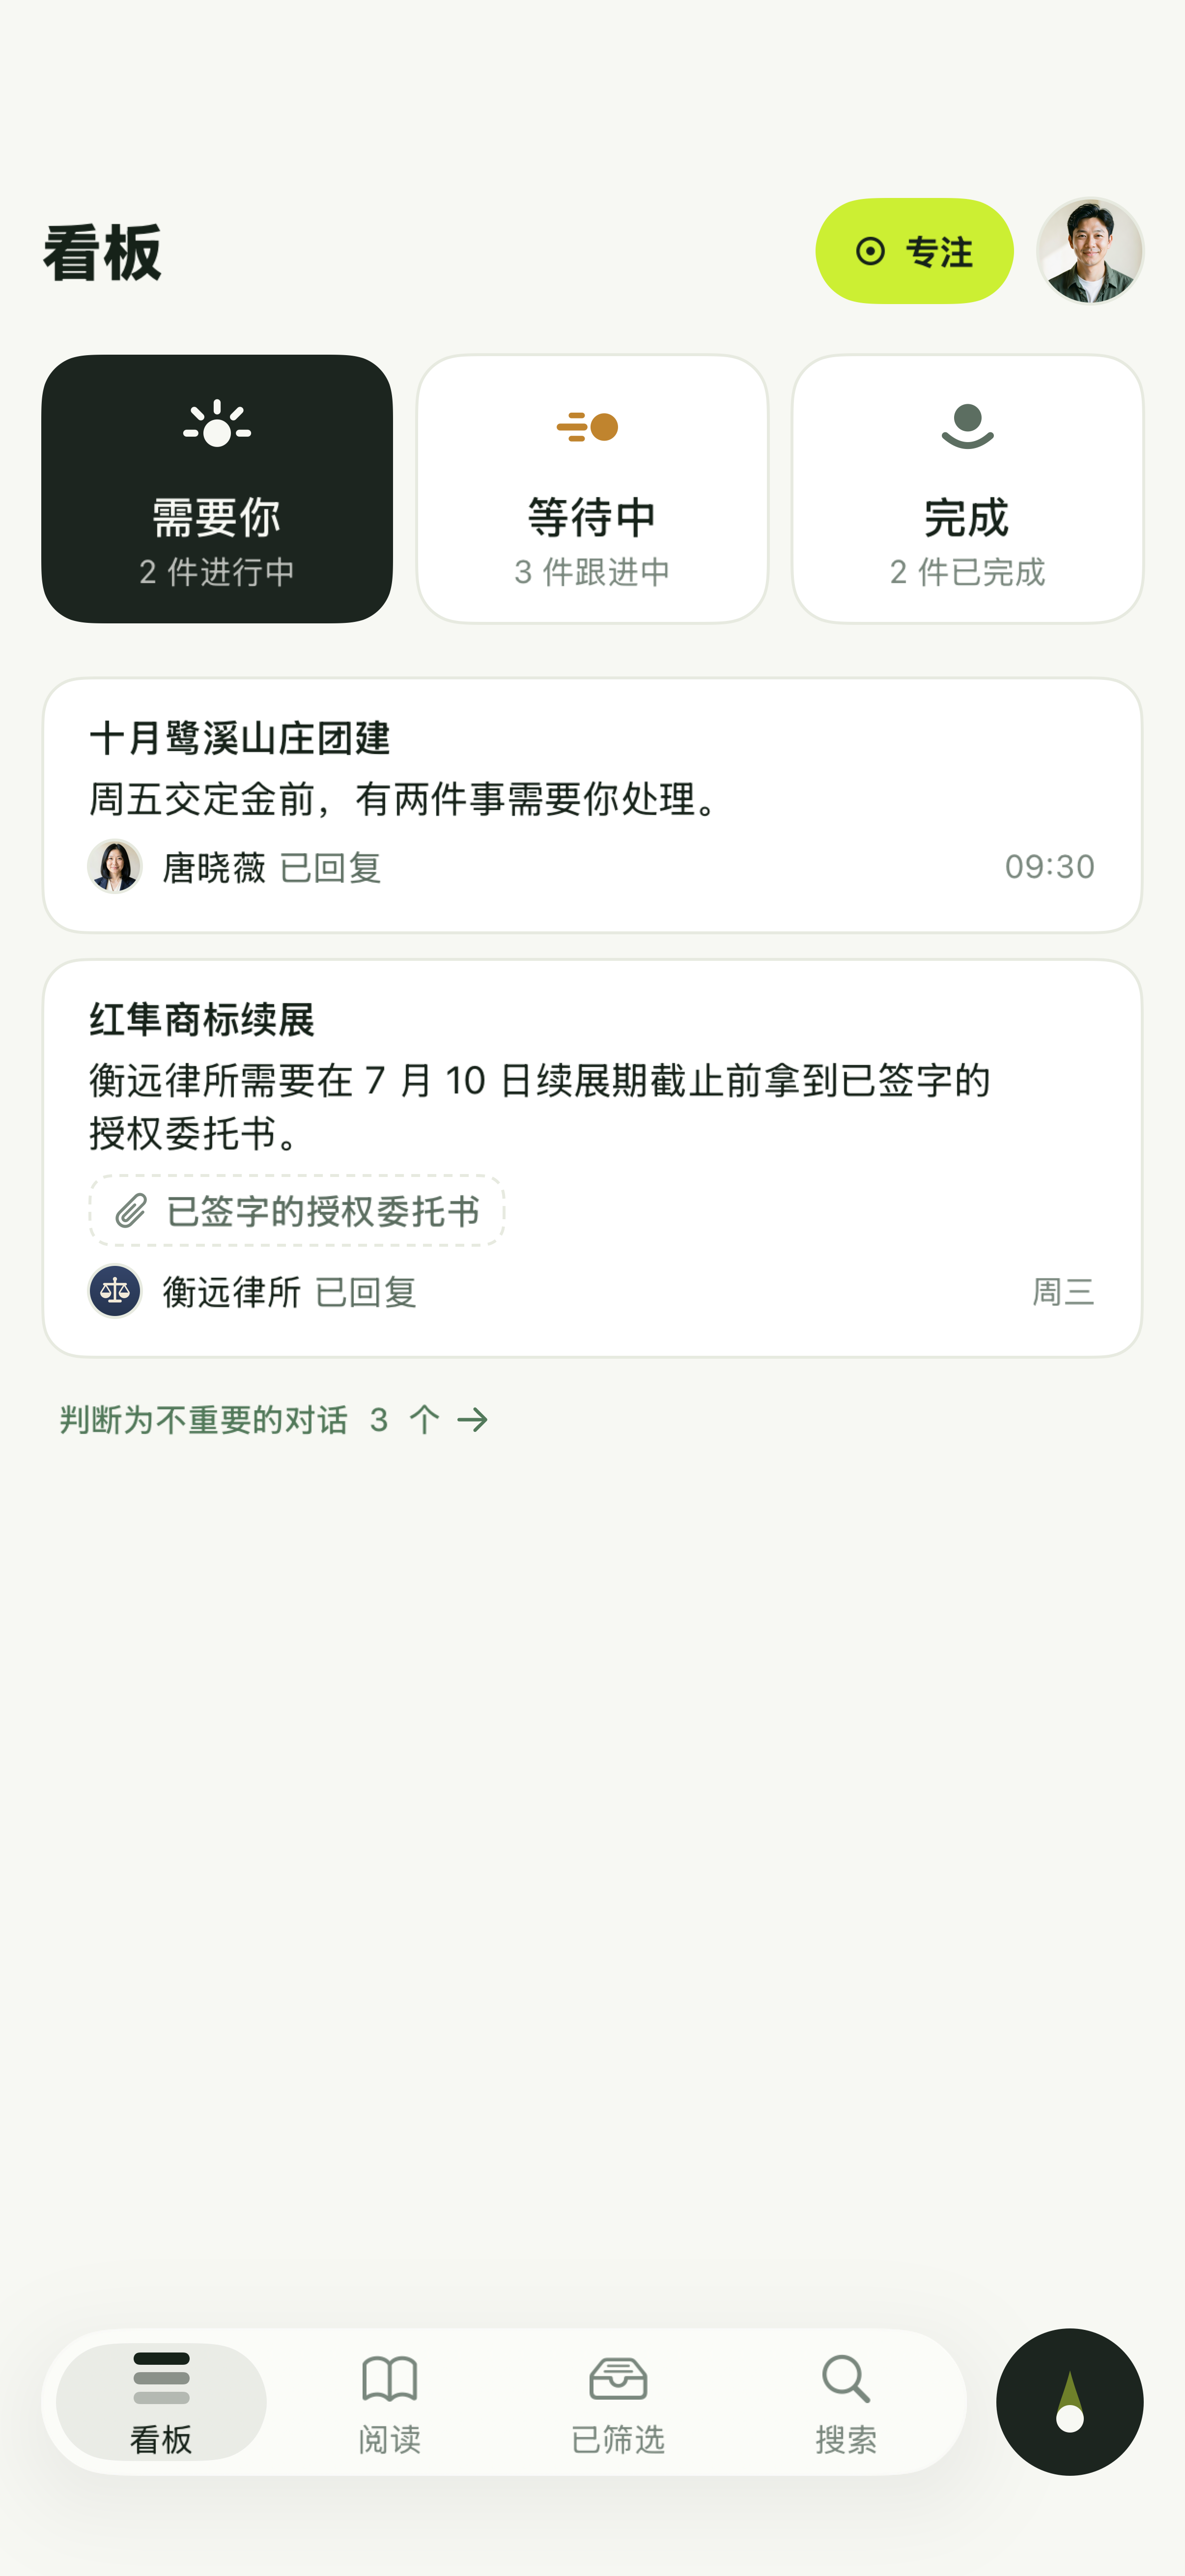
这个判断以事项为单位。Pingbo 读到邮件会话之前,Gmail 已经先过滤掉了垃圾邮件。Pingbo 会把剩余工作整理成事项,再将进行中的事项放入两个区域。放在哪个区域,决定了后续怎样处理。
需要你只列出还等着你处理的事,卡片会写明要做什么。待回复表示邮件里有你应该回答的问题;打开卡片之前,回复草稿就已经准备好了。你可以检查后发送、修改内容,或先和 Pingbo 讨论。待处理表示需要做回复之外的事,例如提交表单或审批发票,卡片会写清楚具体步骤。等你来看时,看板已经整理好昨晚的进展,需要的回复也都备好了。
等待中放的是仍在进行、但今天不需要你采取行动的事。可能是在等别人,也可能只是需要留意进展。Pingbo 会先判断是否需要跟进,定好日期,再按约定提醒你。到了那一天,卡片会重新出现,根据会话记录说明该找谁、问什么。你可以选择现在跟进,也可以点击还没,继续等待。
事项标为完成后,就会移出看板。Pingbo 只会提出结案建议,并附上作为依据的邮件。是否接受由你决定,系统不会自行关闭事项。
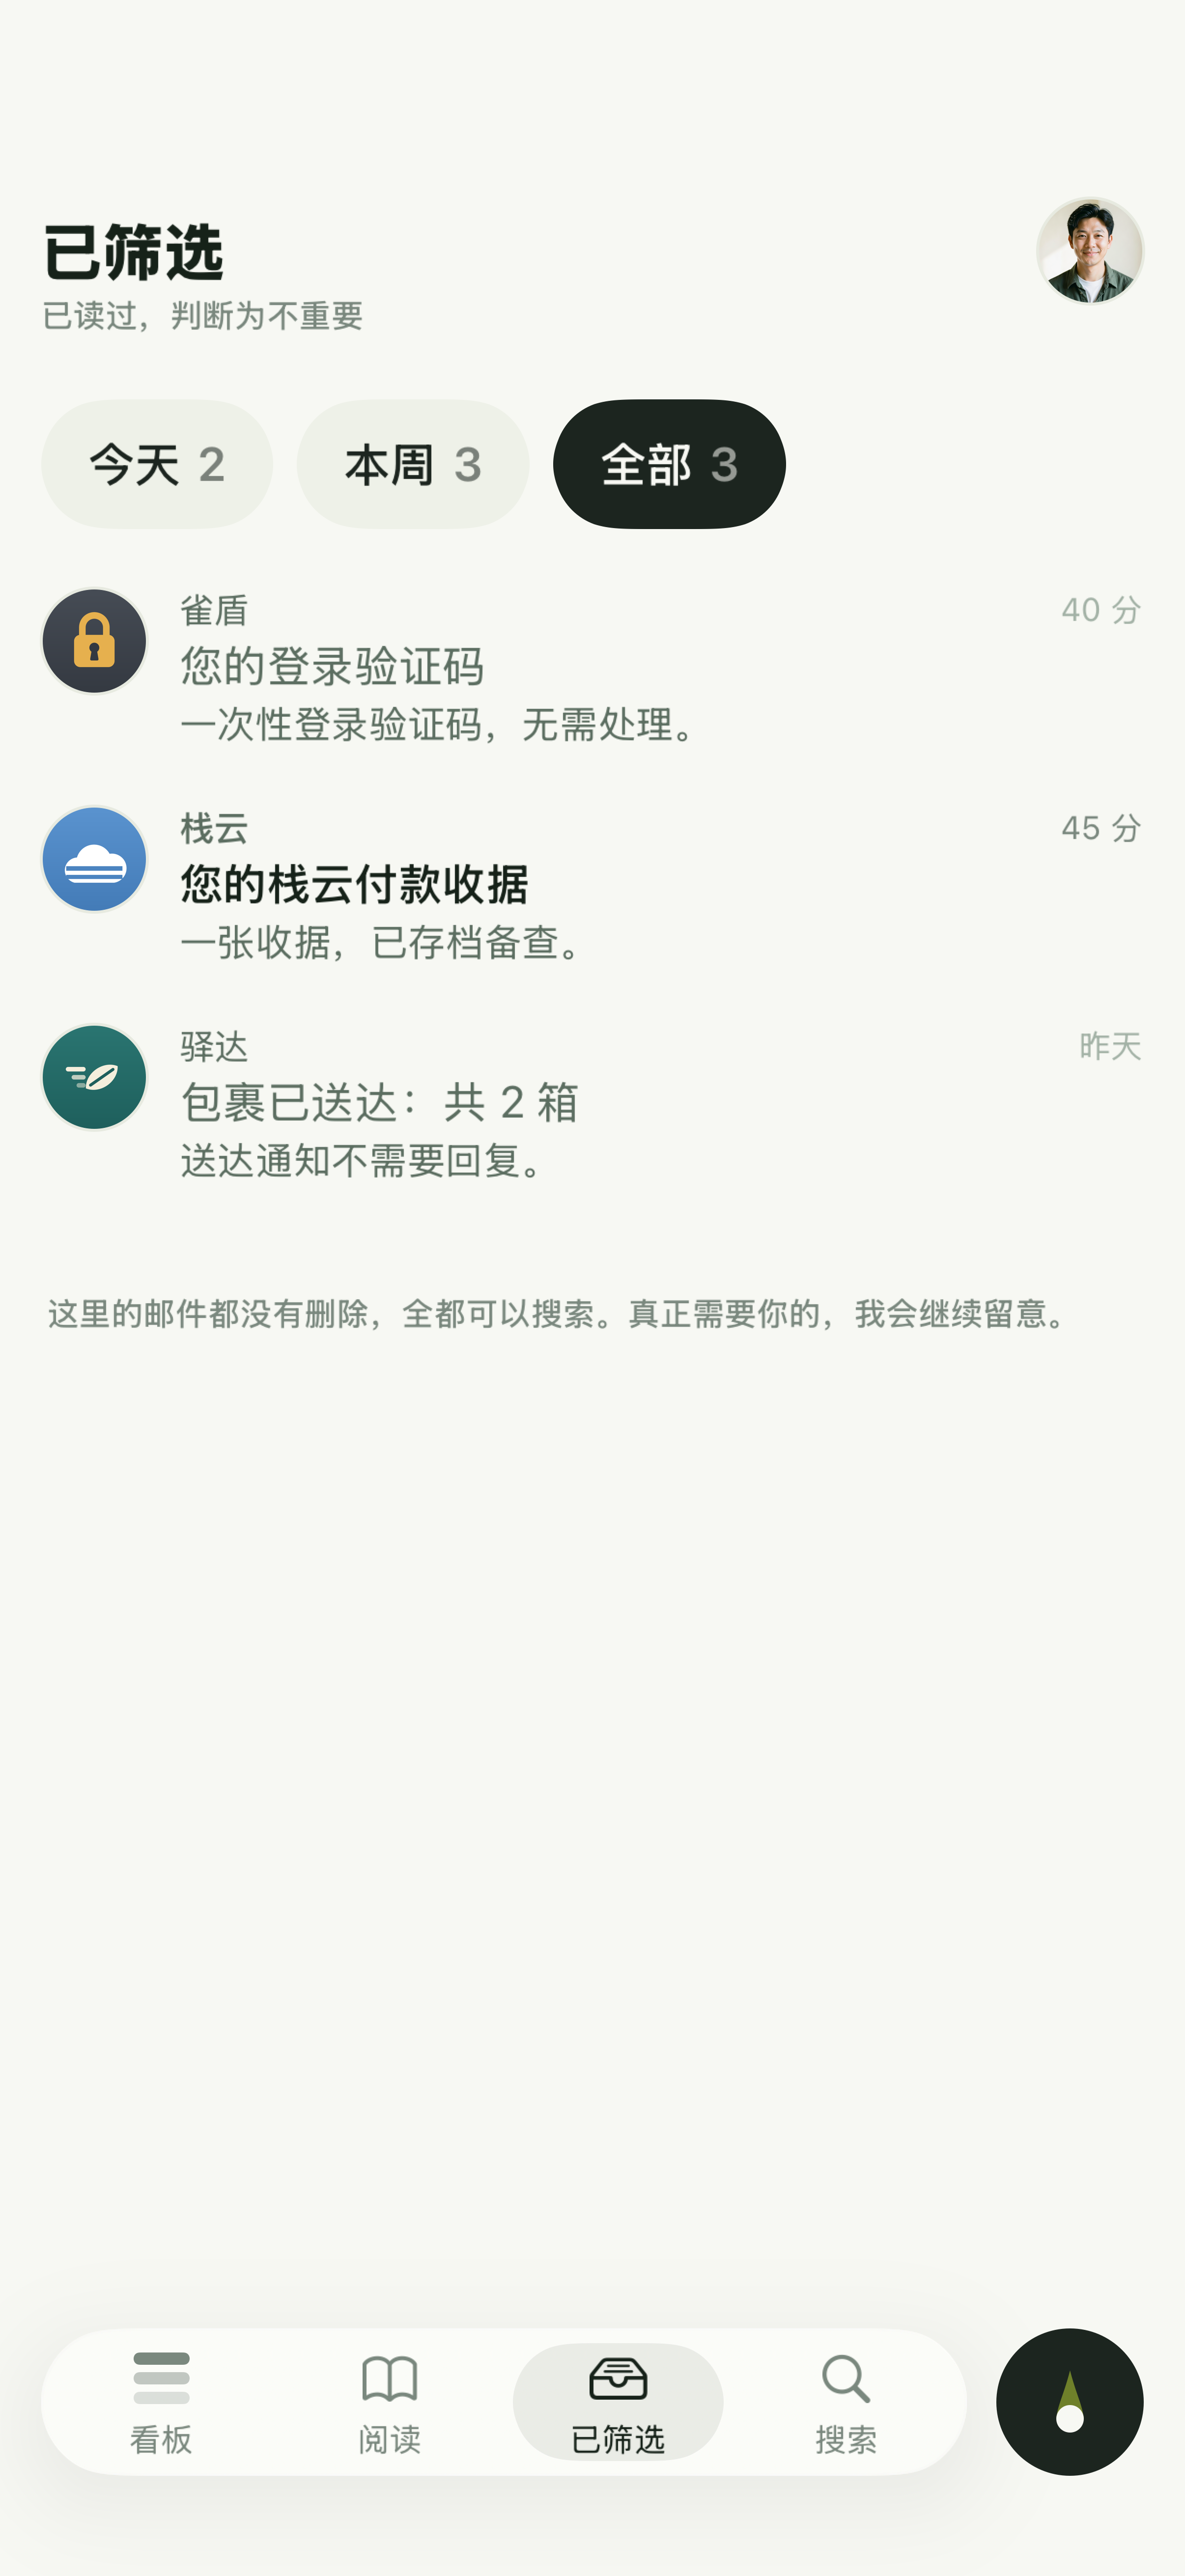
工作之外的邮件也各有去处,不会进入看板。已筛选保留不需要你采取行动的群发邮件、自动通知和参考资料,例如收据、通知,以及你不看的邮件列表。这些邮件都能搜索,不会被删除。阅读则放值得看、看完就好的邮件,例如订阅邮件、进度更新或通知。
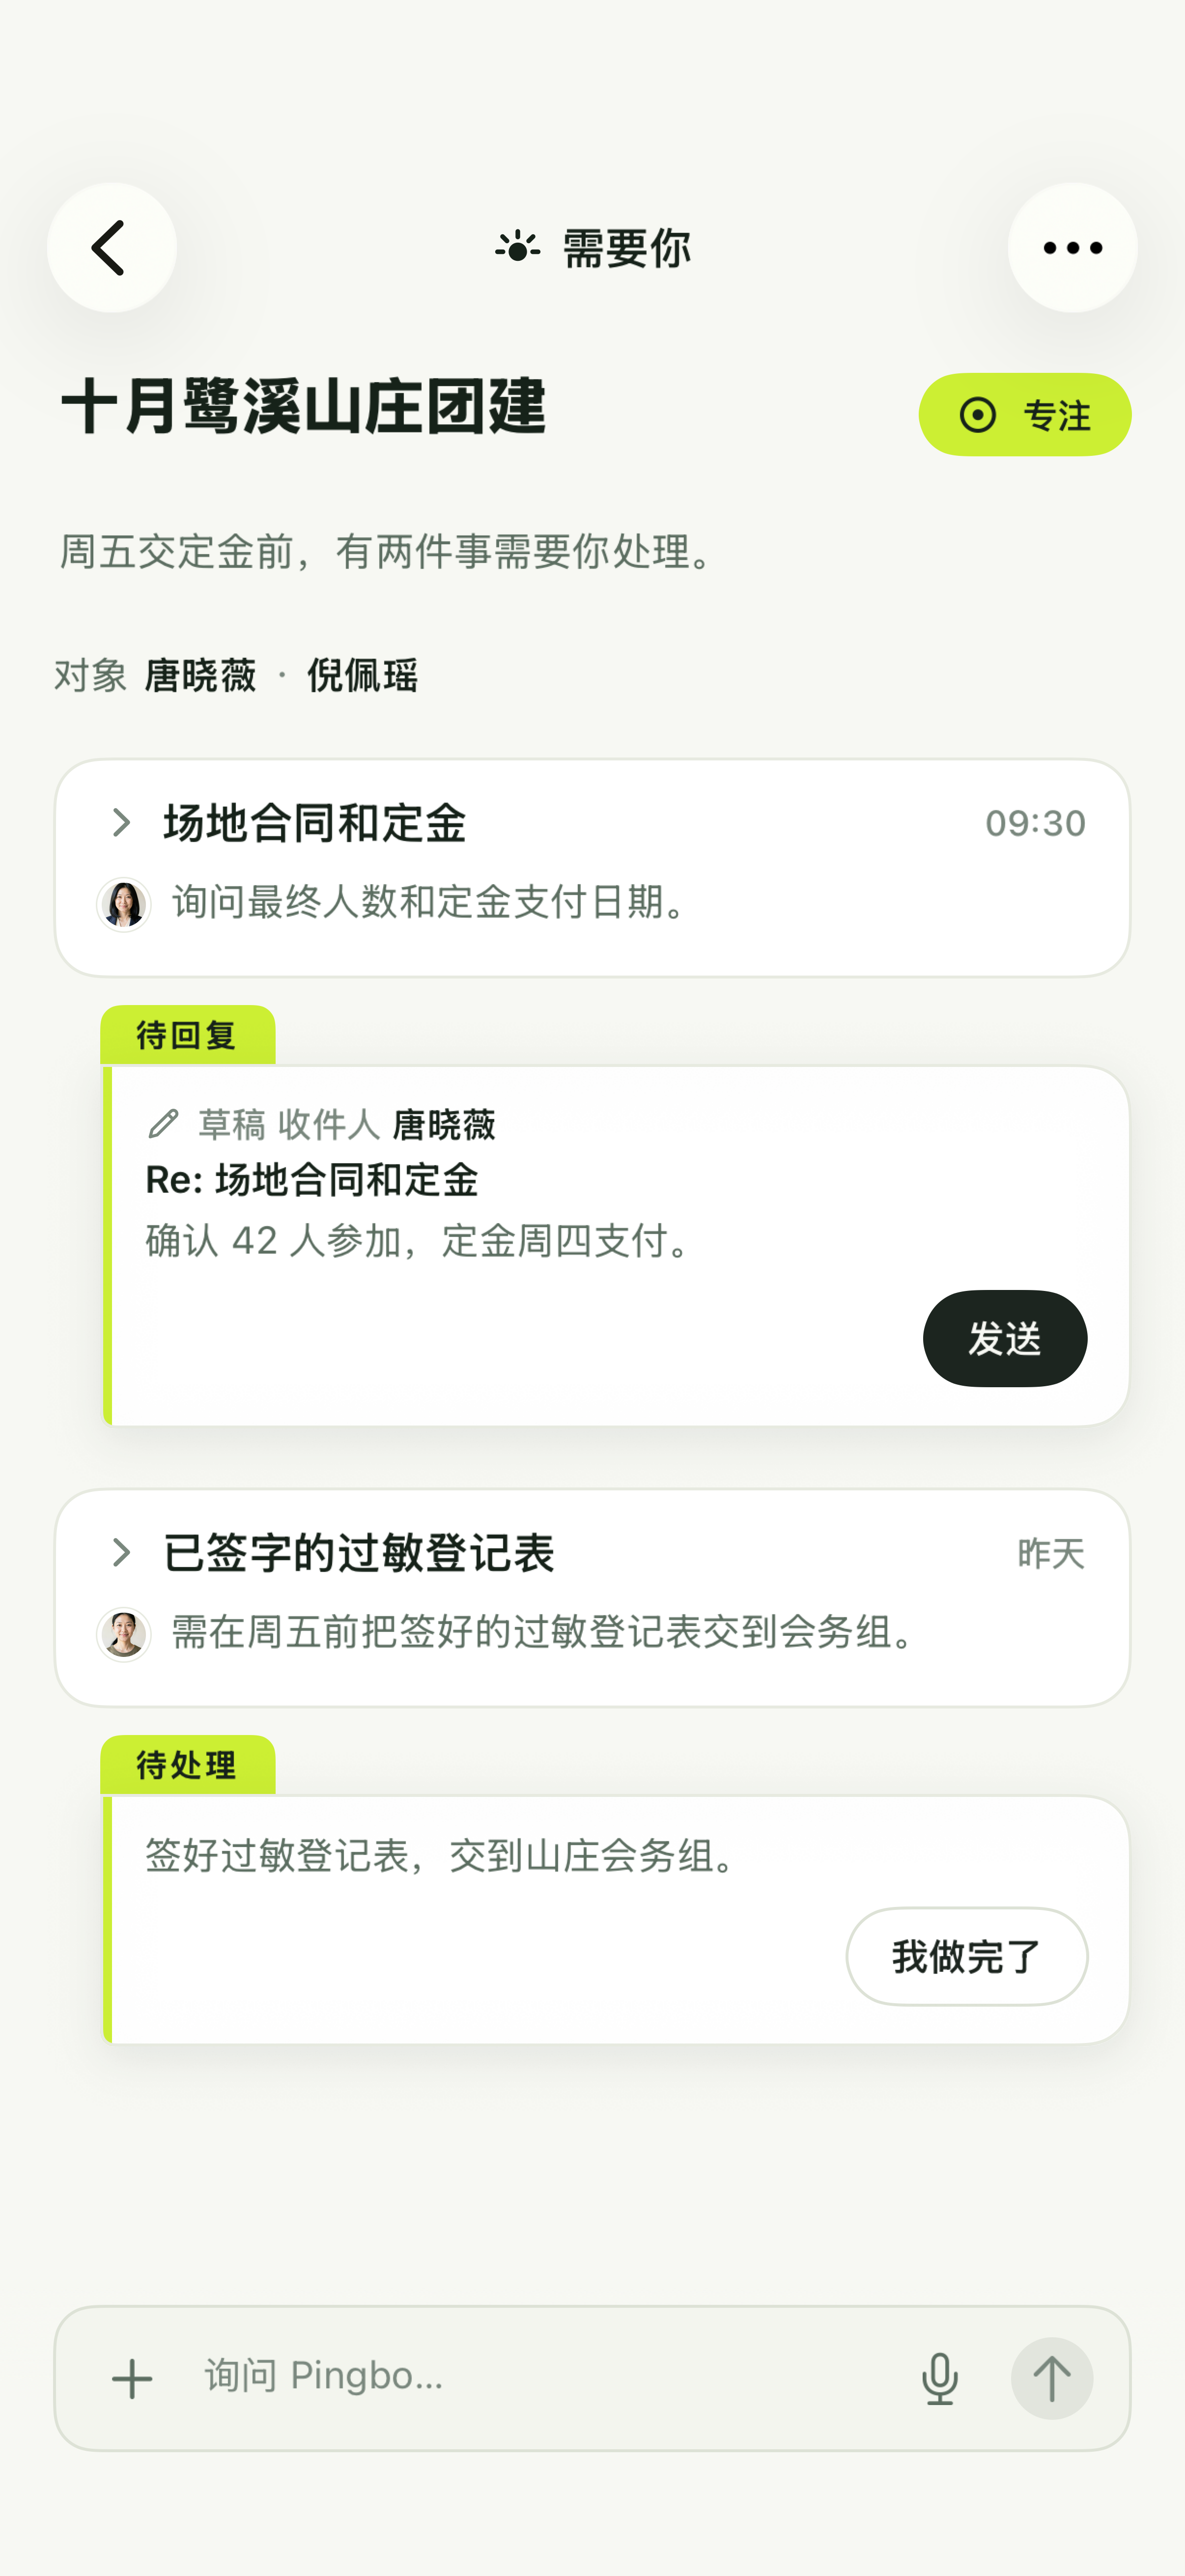
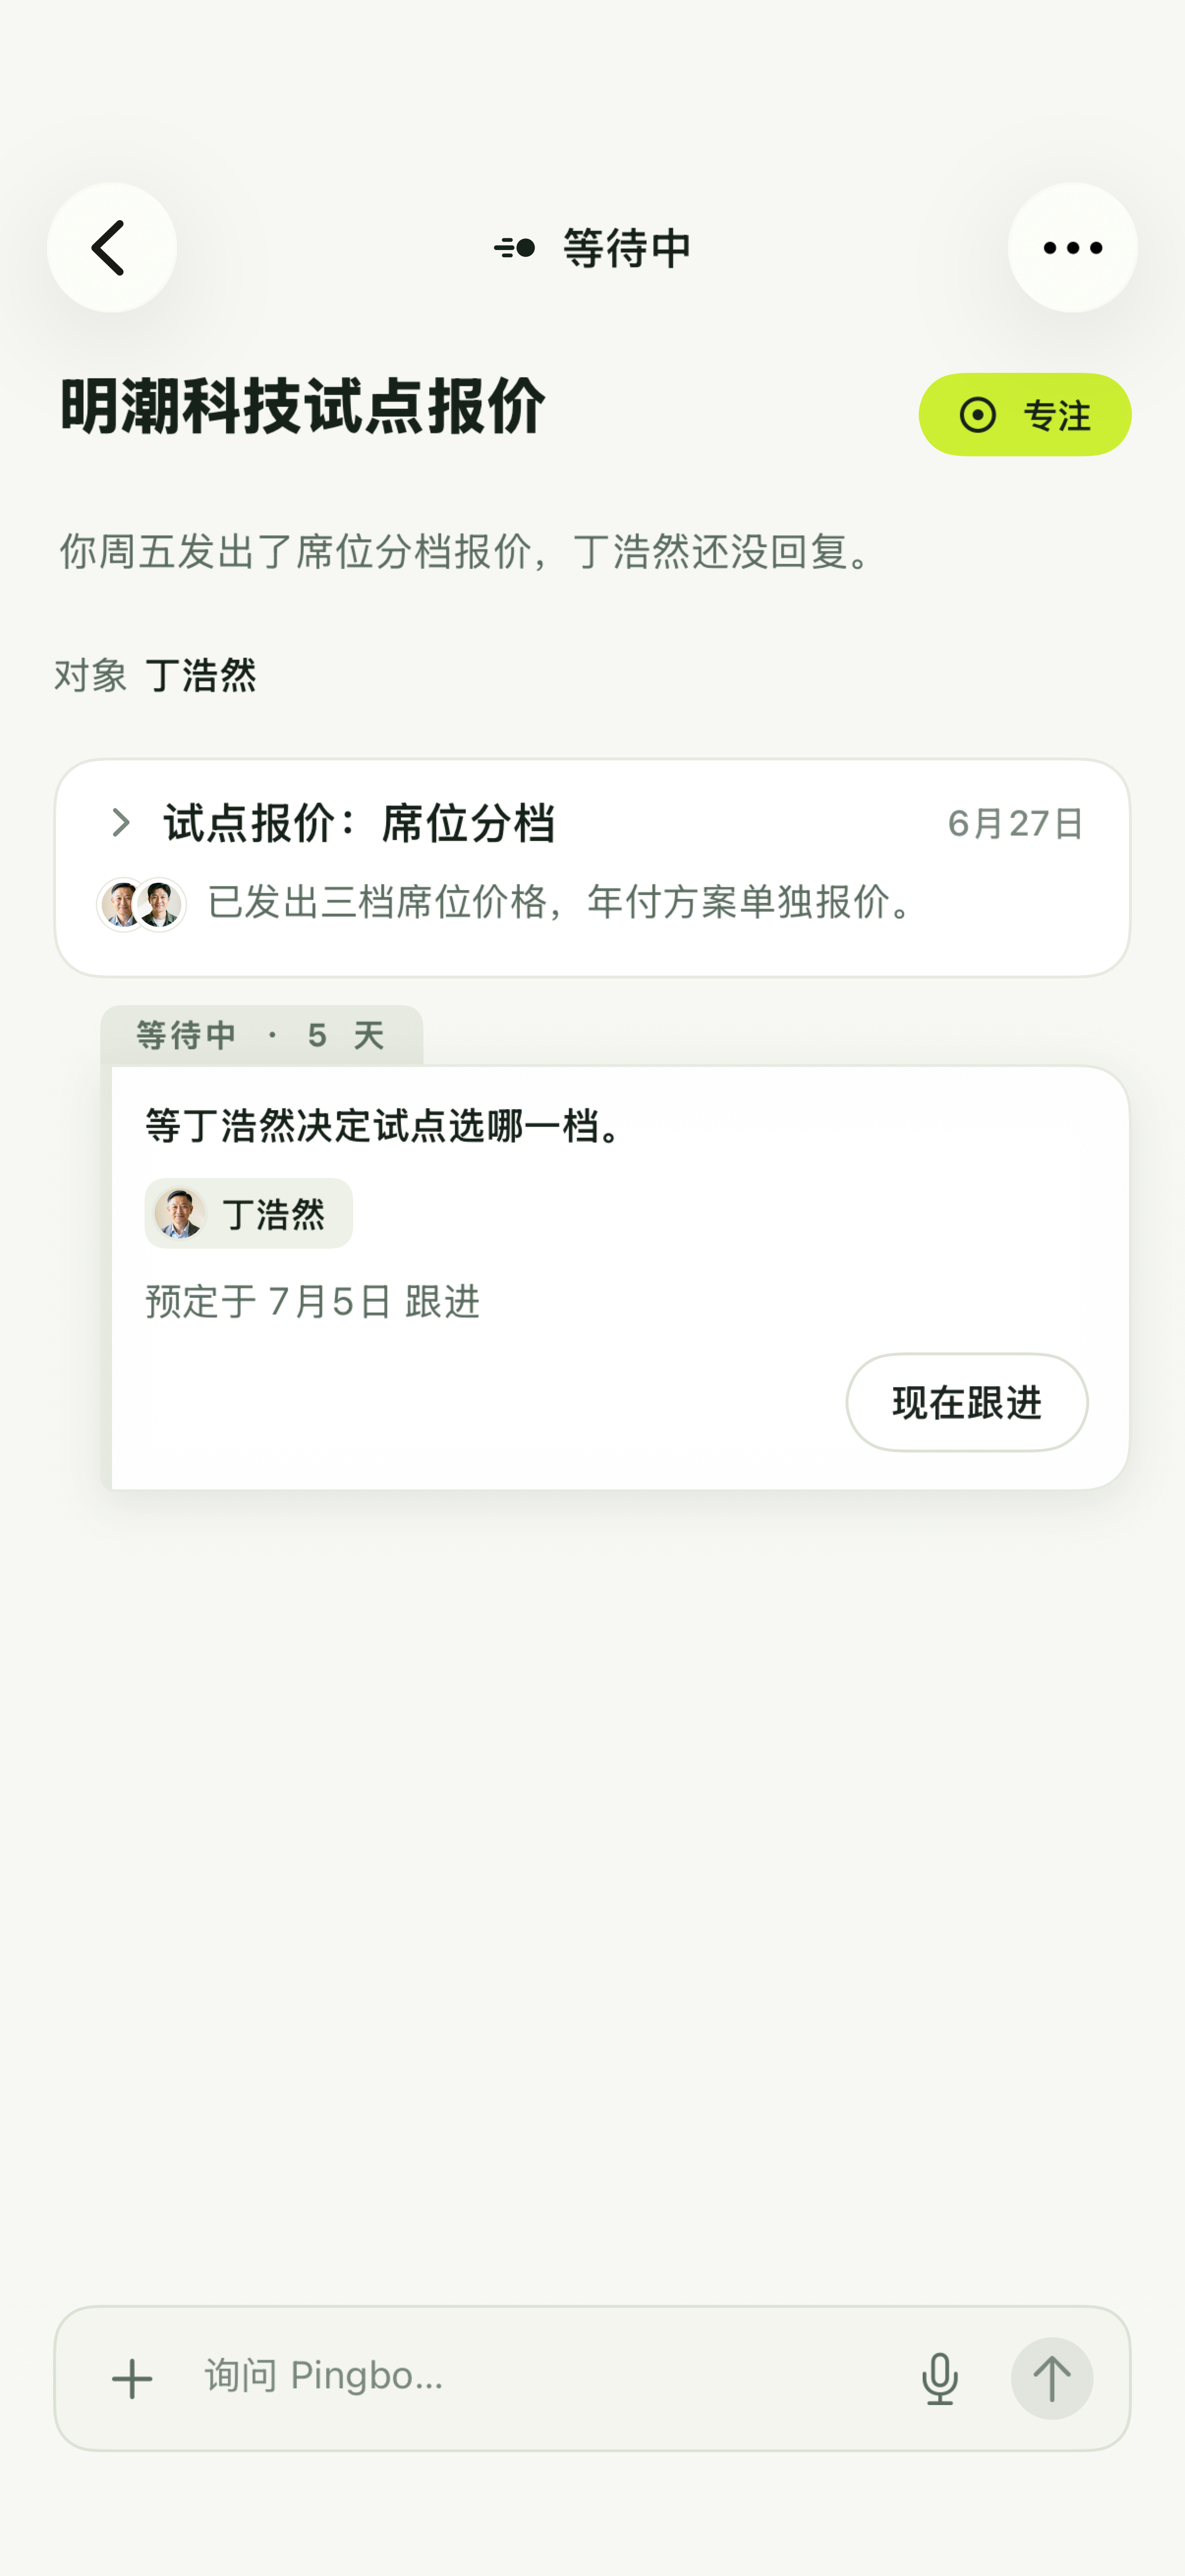
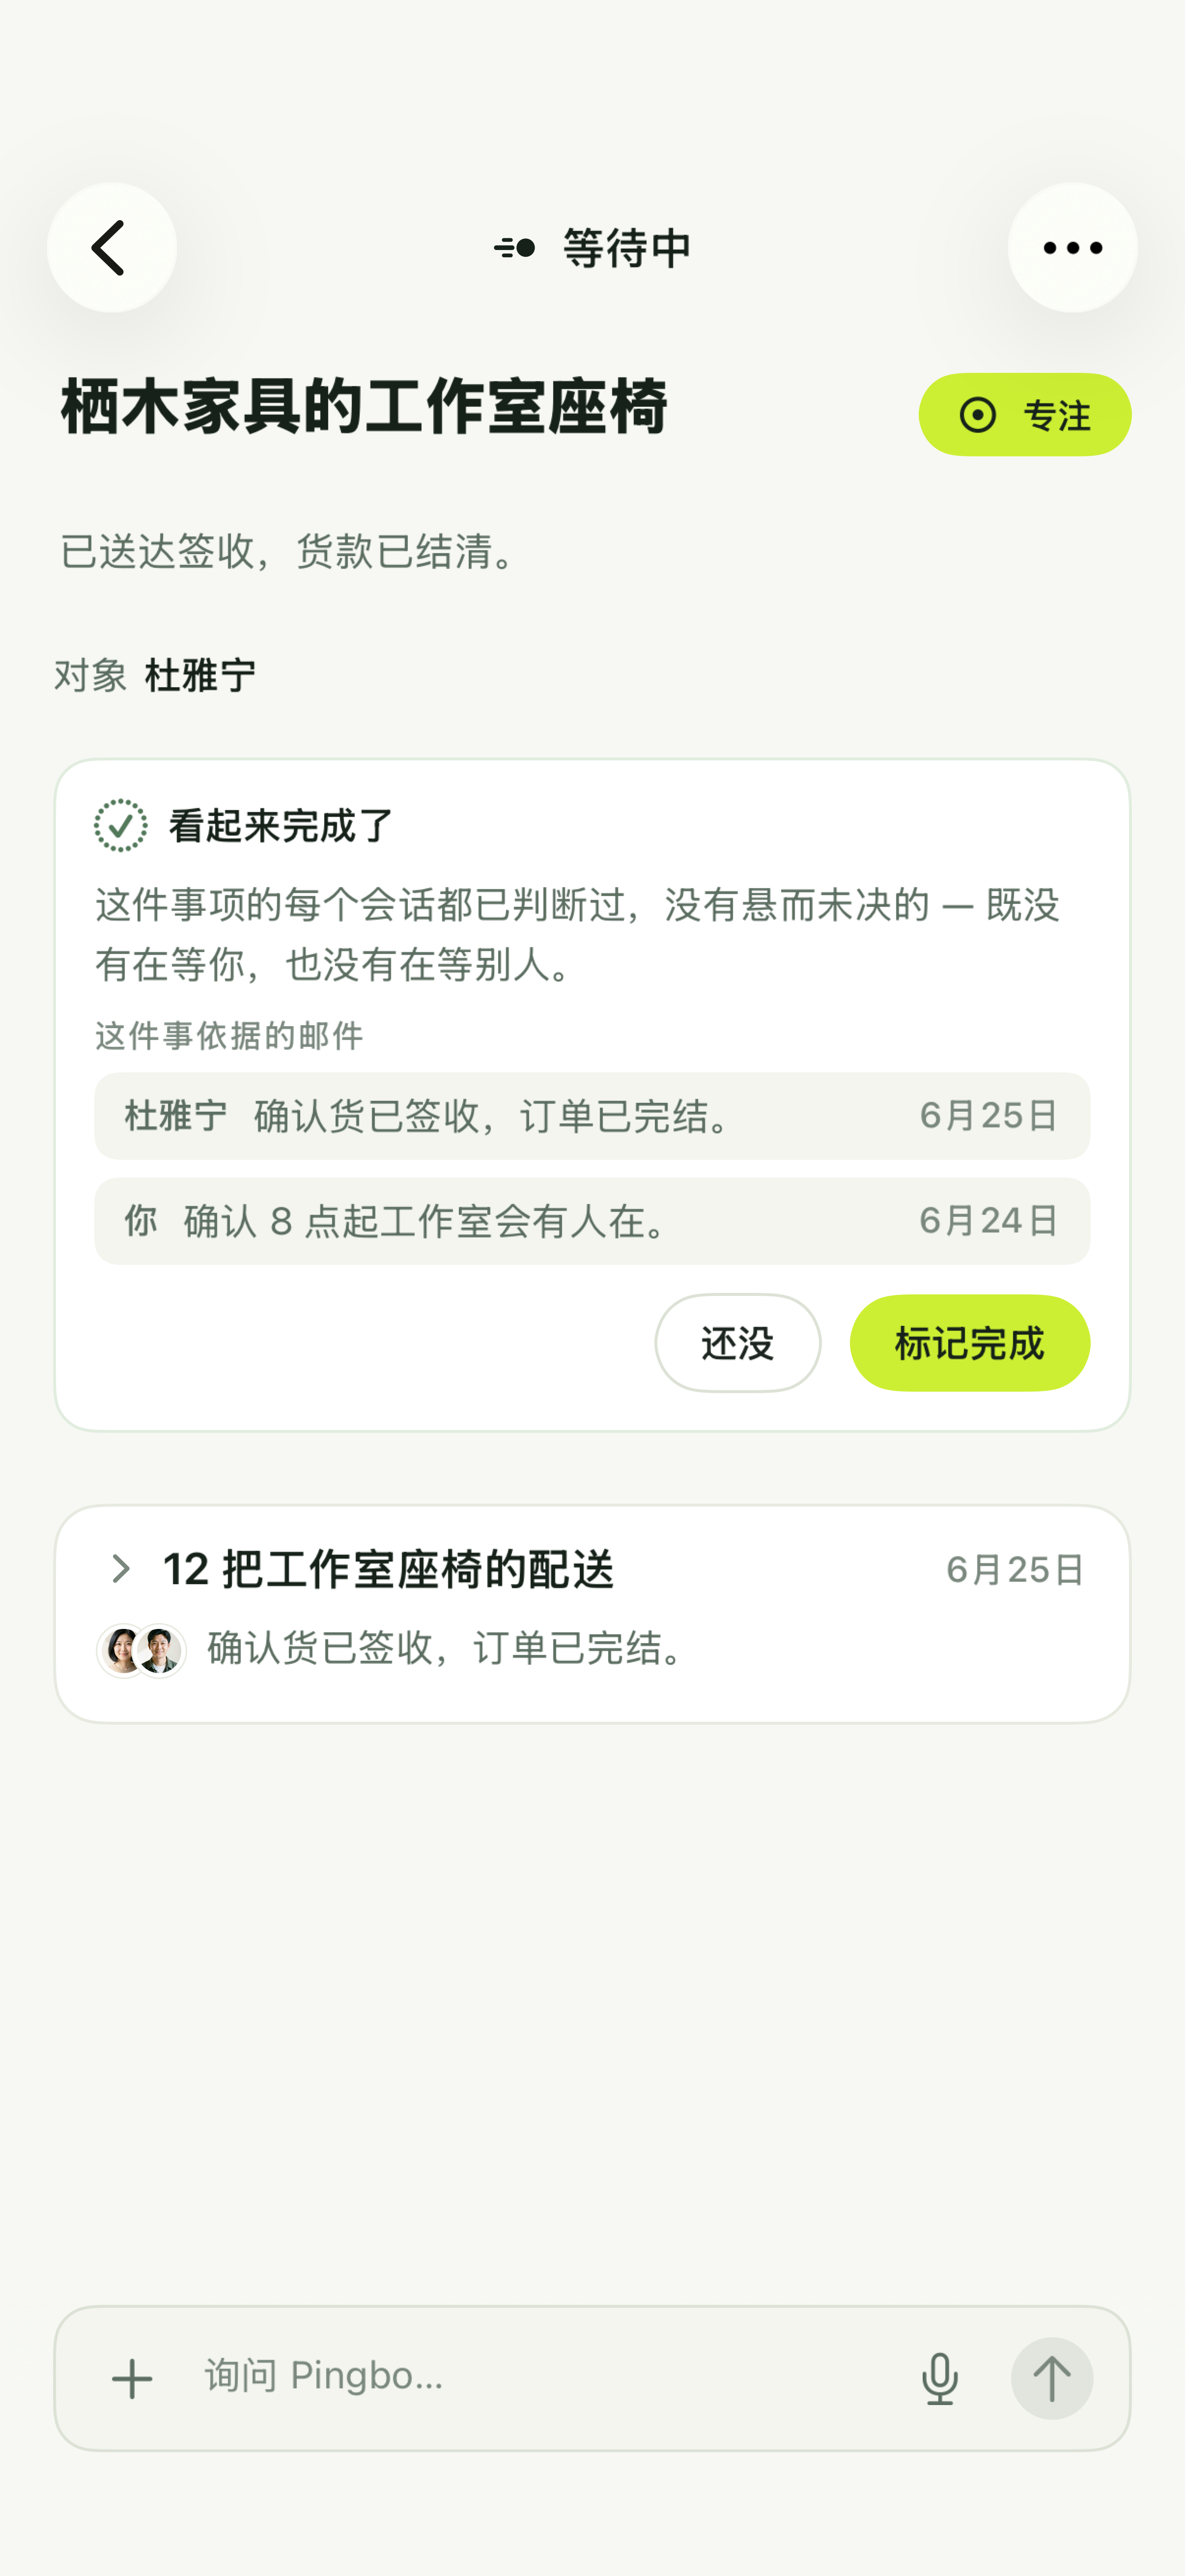
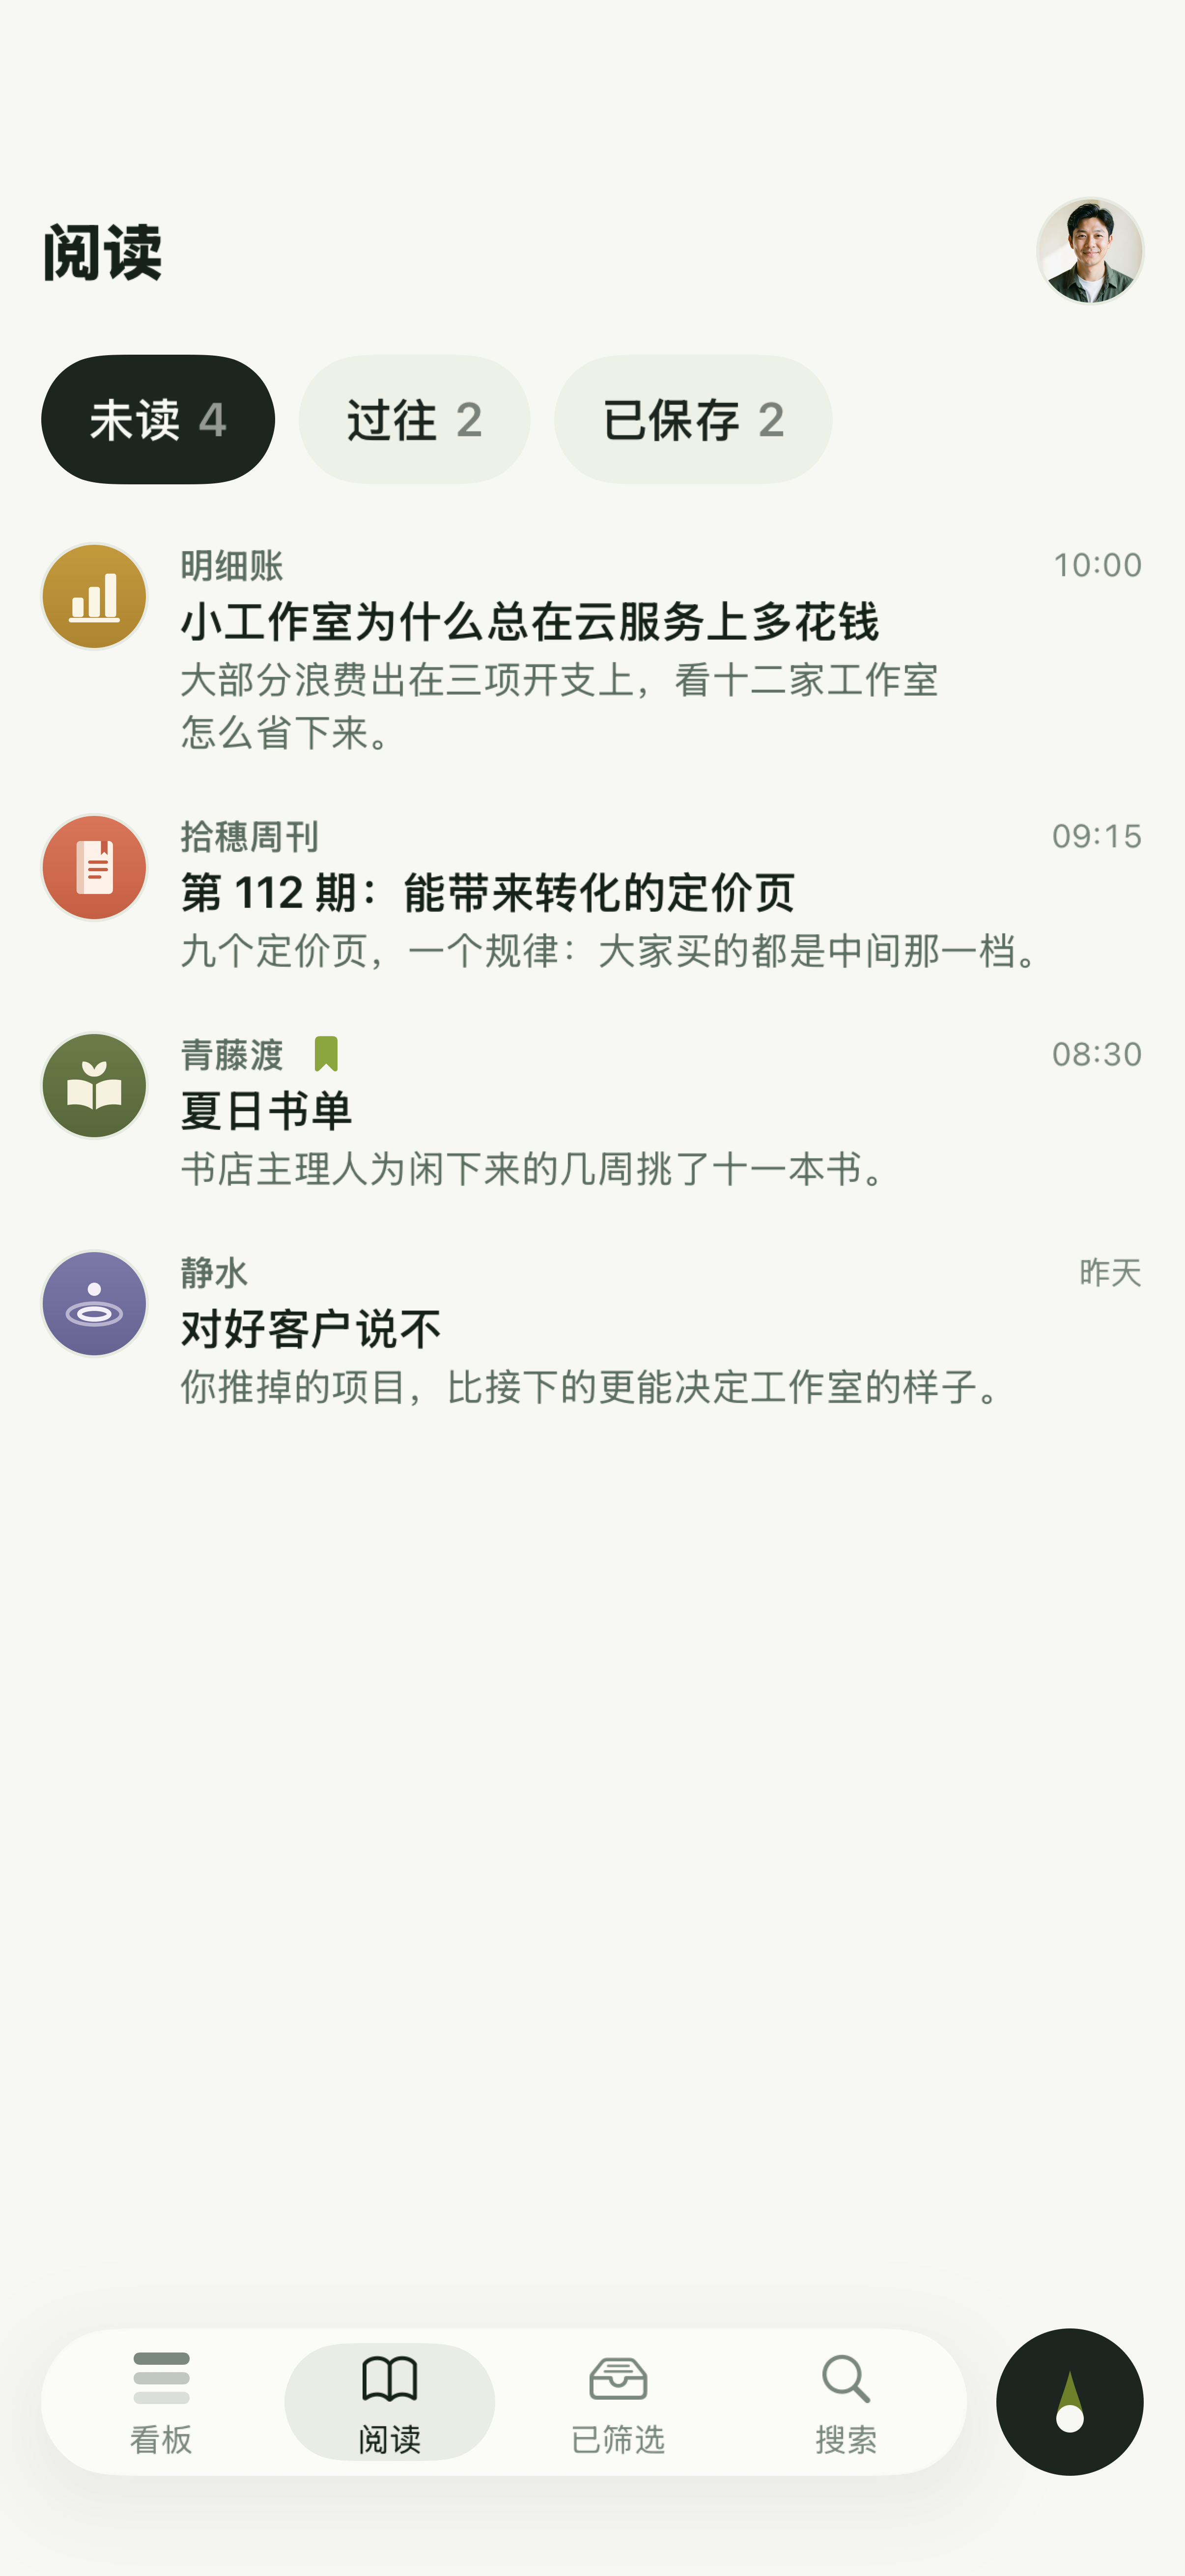
为了做出这些判断,我们让模型按顺序填写一张表,每个答案都会限制下一步能选的内容。模型得先判断现在轮到你还是对方,再决定事项放在哪个区域。接着,从前面介绍的四种状态中选择:需要回信,就附上草稿并标为待回复;需要做其他事,就标为待处理;正在等别人,就放入等待中;会话已经结束,就建议标为完成,由你接受或拒绝。如果模型认为你需要回复,还必须引用会话中提出这一要求的原文,不能只凭推测。
有了这套流程,模型的回答才能用于整理事项、准备草稿和安排下一步。但每多一个判断环节,也就多一个可能出错的地方,比单纯回答“是”或“否”更难。我们不能只相信模型说了什么,必须实际测试。
用什么标准衡量
我们用 508 封真实工作邮件评分,数据集来自 Sappelli 等人(2016),Information Sciences,邮件正文则从 Enron 邮件档案中取得。原研究由两位标注者阅读 1,145 封邮件,分别记录每封邮件要求收件人做什么。我们只采用两人判断一致的 508 封。如果两个人仔细读完都得不出相同结论,那封邮件就不该拿来给任何人打分。
原研究把邮件分为四类:112 封需要立即回复;67 封需要稍后回复,也就是该回,但不必今天回;285 封属于应当知悉、但不必回复的内容;44 封可以忽略。Pingbo 要判断的是什么样的事项需要你的注意,因此前两类合并为需要你;应当知悉的邮件对应等待中,可以忽略的邮件在 Pingbo 里则会被已筛选挡在看板之外。这次评测评分的只有一件事:这封邮件需不需要回复。所以也就是 112 + 67 = 179 封需要回复,285 + 44 = 329 封不需要回复。
这个比例给出了最基本的比较基准。如果对 508 封邮件全部回答“不需要回复”,会答对 329 封,同时漏掉全部 179 封该回的邮件。即使一个字都没读,准确率也有 329 ÷ 508 = 64.8%。低于这个分数,就比什么都不做还差。
准确率是整体判断正确的比例,却不能单独说明错在哪里。两个系统都可能得到 80%,也就是 508 封中答对 406 封。其中一个找出 179 封里的 77 封,没有多列任何不需要回复的邮件;另一个找出 160 封,却多列了 83 封不需要回复的邮件。两者同分,但前者漏掉了 102 封该回的邮件,后者只漏了 19 封。因此,我们同时公布三项指标:准确率,看整体答对多少;召回率,看该回的邮件找出了多少;精确率,看列出的邮件有多少确实需要回复。
我们用这套标准检验 32 个模型,选这些模型是为了回答三个问题。OpenAI 的 16 个模型和 Anthropic 的 11 个模型,让我们了解目前领先模型的能力;在自有硬件上运行的开放权重模型 Qwen3.6,让我们知道不租用外部模型时,Pingbo 能做到什么程度;另外四个小模型,则让我们看到手机能承担多少这项工作。Gemma 和两个版本的 Ornith 小到未来可能在手机上运行;Apple 的设备端模型支撑着 iOS 26 和 macOS 26 中的 Apple Intelligence,较新的 iPhone 已经内置了它。Qwen3.6 和这四个模型共五个,都在我们自己的机器上运行,所以图表把它们归为自托管。全部 32 个模型都测试了同样的 508 封邮件。
不过,这份数据集不是为 Pingbo 设计的,所以在相信任何数字之前,我们先检查了数据集本身。两位标注者的分歧最集中在四分类标签上;Pingbo 实际评分所用的二选一问题,和收件人实际有没有回信对得上;重新盲评的 100 封邮件中,有 24 封第三位读者在这个问题上与数据集判断不同。想了解评测方法的读者,可以参考文末的附录。
从简单的模型提示词,到完整的产品框架
Pingbo 除了模型,还有我们自己开发的执行框架,包括前面的表格、答案检查,以及结果呈现给你之前的处理程序。加上这些流程,可能让模型表现更好,也可能更差,必须测试才知道。因此,每次改动后,我们都用相同的 508 封邮件重测全部 32 个模型,其他条件保持不变,分数的变化才来自这次修改,而不是换了一批邮件。每一轮都只跑一次,模型自己的答案在不同次之间也会有些出入,所以一两封邮件的差别不值得细究。图 2 记录了每一轮结果。
OpenAI 16
- gpt-5.6-luna
- gpt-5.6-sol
- gpt-5.6-terra
- gpt-5.5
- gpt-5.4
- gpt-5.4-mini
gpt-5.4-nano- gpt-5.2
- gpt-5.1
- gpt-5
- gpt-5-mini
gpt-5-nano- gpt-4.1
- gpt-4.1-mini
gpt-4.1-nano- gpt-4o-mini
Anthropic 11
- claude-opus-5
- claude-opus-4-8
- claude-opus-4-7
- claude-opus-4-6
- claude-opus-4-5-20251101
- claude-fable-5-1
- claude-fable-5
- claude-sonnet-5
- claude-sonnet-4-6
- claude-sonnet-4-5-20250929
- claude-haiku-4-5-20251001
自托管 5
- qwen3.6-35b-a3b-mxfp4
- ornith-1.5-9b-mlx-full
ornith-1.5-9b-mlx-6bit- gemma-4-E4B-it-qat-4bit
apple-fm-on-device
第 0 步不加任何执行框架,直接把邮件交给每个模型。模型读完一封邮件,从两位标注者用的四个类别里选一个,我们再按本文统一的评分方式,只看这个答案意味着需不需要回复。32 个模型的中位数是 77.0%,也就是有一半模型的成绩高于这个数字;有 29 个超过比较基准,说明模型本身已经能完成大部分判断。但只给出一个类别,还不能成为产品:它没有告诉你该找谁跟进,没有准备草稿,也没有在看板上安排下一步。
第 1 步,我们首次要求模型填完整张表,成绩反而下降。模型一旦需要填满各个字段,就开始替你安排本来不存在的工作。例如,同事只是发来修订稿,没有提出任何要求,系统却建议“回复意见或批准”。中位数降到 65.0%,几乎只剩最基本的水平,也只剩 17 个模型超过比较基准。与直接回答问题相比,32 个模型中有 28 个因为加了框架而退步。这次问题出在我们设计的流程。
第 2 步就是针对这个问题修改。模型要判定你需要回信,就必须引用要求回复的原文;程序还会到邮件中核对,确认这段话确实存在。找不到引用,就不能判定需要回复。中位数因此提高到 81.3%,24 个模型超过比较基准,32 个中有 23 个在框架内的表现不低于直接回答问题。这是第一次,多数模型没有因为这套流程而退步。
第 3 步的修改,来自我们重新检查第 2 步采用的引文。其中有五分之一出自邮件下方附带的旧会话,而非这次发来的新内容。发件人正在回答此前收到的问题,系统却把那个旧问题误认为他现在对你提出的要求。其他误判还包括结尾的客套话,以及需要列入待办、但不用回信的工作交接。因此,我们进一步限制:请求必须出自当前这封邮件,而且是发件人亲自写的内容。中位数提高到 82.5%,27 个模型超过比较基准,最高分是 85.0%;32 个中有 25 个,在框架内的表现优于直接回答问题。
第 3 步对用户最有意义,却是图 2 中最不容易看出差别的一轮。我们在自有硬件上运行的模型,因此提高了 6.3 个百分点,与其他模型的差距从 7.9 个百分点缩小到 2.8 个百分点。这说明判断质量也来自 Pingbo 自己的流程;即使更换底层模型,这些改进仍然有效,不必完全依赖当下最强的模型。
但规则更严格也有代价,只是单看一个数字容易误解。在同一个模型上,该回的邮件拿到待回复卡片的比例,从 68.2% 降到 62.0%;待回复卡片中确实该回的比例,则从 61.6% 提高到 76.6%。失去待回复卡片的 19 封该回邮件里,有 18 封变成了待处理卡片,仍然留在清单上,因此最后进入等待中的,从 13 封减到 10 封。每轮修改都有这样的取舍,所以我们每次都重测三项指标,确认改善了什么、又牺牲了什么。执行框架也不是对所有模型都有帮助:32 个中仍有七个直接回答问题反而表现更好,其中多数是规模最小或压缩幅度最大的模型。因此,Pingbo 选模型时权衡的是成本与实测表现,不能只看价格。Apple 的设备端模型最能说明这个限制。直接提问时,准确率有 70.1%,高于比较基准;放进执行框架后,每一步都低于比较基准。第 3 步中,它连同 Pingbo 的指令一次最多只能读 4,096 个 token,约合 3,000 个英文单词,508 封邮件里有 153 封放不进去;其余 355 封中,有 306 封在它首先判断邮件该归到哪里时,就被规则驳回。没有一封邮件成为事项,自然也没写出任何回复草稿。模型要先撑得起执行框架,框架才帮得上忙。
第 3 步就是 Pingbo 目前采用的处理流程。接下来要决定的,是这套流程该用什么设置,才适合你。
选择漏掉邮件,还是减少打扰次数
同一套流程可以偏向减少提醒,也可以偏向尽量找出所有该处理的邮件。图 3 列出每个模型在不同设置下的表现。
OpenAI 16
- gpt-5.6-luna
- gpt-5.6-sol
- gpt-5.6-terra
- gpt-5.5
- gpt-5.4
- gpt-5.4-mini
gpt-5.4-nano- gpt-5.2
- gpt-5.1
- gpt-5
- gpt-5-mini
gpt-5-nano- gpt-4.1
- gpt-4.1-mini
gpt-4.1-nano- gpt-4o-mini
Anthropic 11
- claude-opus-5
- claude-opus-4-8
- claude-opus-4-7
- claude-opus-4-6
- claude-opus-4-5-20251101
- claude-fable-5-1
- claude-fable-5
- claude-sonnet-5
- claude-sonnet-4-6
- claude-sonnet-4-5-20250929
- claude-haiku-4-5-20251001
自托管 5
- qwen3.6-35b-a3b-mxfp4
- ornith-1.5-9b-mlx-full
ornith-1.5-9b-mlx-6bit- gemma-4-E4B-it-qat-4bit
apple-fm-on-device
| 需要你列入哪些卡片 | 找出几封需要回复的邮件(共 179 封) | 列出的邮件中,需要回复的比例 | 列出的邮件总数 |
|---|---|---|---|
| 只列待回复 | 119 (66%) | 89% | 133 |
| 加入待处理:Pingbo 的默认设置 | 150 (84%) | 62% | 241 |
| 再加一次独立判断 | 159 (89%) | 60% | 265 |
表 1。在实测表现最好的 gpt-5.5 上,以三种设置建立需要你列表。三行都采用第 3 步的流程,只是设置不同。最后一行找出最多该回的邮件,但也会列出收件箱中超过一半的邮件。
表 1 第一行只列出待回复卡片。第二行加入待处理,也是 Pingbo 的默认设置。第三行则再让模型对每个事项独立判断一次。
两位标注者只记录了邮件是否需要回复。需要你的范围更广,还包括要求你采取其他行动的邮件,但数据集没有标记这一类。第二行显示 241 封,第一行是 133 封,多了 108 封。其中 31 封,两位标注者都认为需要回复,因此找出的该回邮件从 119 封增加到 150 封。剩下 77 封在评分时被算作错误,却不能因此认定 Pingbo 不该把它们列出来,因为数据集根本没有“需要采取行动”这个标记。有些正是需要你应该列出的工作,有些才是误判;现有数据无法区分,我们也就不替它们下结论。这正是表格中间那一栏从 89% 降到 62% 的原因。
Pingbo 没有列出来的邮件,同样需要衡量。在 Pingbo 的默认设置,也就是表 1 第二行中,gpt-5.5 列出 241 封,其余 267 封没有进入需要你。179 封该回的邮件中,它找出了 150 封,因此有 29 封该回却仍然没被列出;另外 238 封被标注为不需要回复。要做的工作,就是把这 29 封降下来。
这 267 封的去处并不相同,标签也没有说这些邮件不需要你做任何事。Pingbo 把其中 46 封放进等待中,124 封放进完成;95 封根本没有成为事项,而是进了阅读或已筛选;还有两封是模型调用失败。标注者记录的只有邮件是否需要回复,此外什么都没有记,所以这里的数字没有一个能说明,其中某一封是不是仍然有事要找你。
在这个模型、这几种设置下,两项指标无法同时做到最好:想少漏几封该回的邮件,就得接受多看几封不需要处理的邮件;如何取舍,仍然需要人来判断。但这不是定律。32 个模型中有五个,在加上这一次独立判断之后,两项指标一起提高,claude-opus-5 也在其中,因为这次判断补回了它们的流程原本漏掉的邮件,列出的邮件却没有多出那么多。两种错误的代价并不相同:漏掉一封需要你的邮件,对方可能一直等不到回复,你甚至不知道这件事;多列出一封不需要你的邮件,通常只花你一秒确认。
Pingbo 现在能做到什么
在这次评测中,我们统计了 Pingbo 找出了多少需要回复的邮件,以及有多少没有列进“需要你”。这 508 封邮件虽然能帮助我们找出适合多数人的做法,却无法告诉我们什么适合每一位用户。例如,初创公司的创始人可能希望看到投资人的每一封回信,再短也不能漏;公司主管整天收到抄送邮件,却可能只想看到少数真正需要自己处理的邮件。同一个标准,无法同时满足两种需求。
这份数据集本身也不完美,附录有详细说明。即使只问“是否需要回复”,两位标注者的一致率仍然只有 70%。到了某个程度,再追求更高分,反映的可能只是模型更符合标注答案,未必是 Pingbo 更好用了。实际邮件的情况往往更复杂:会话更长、参与者更多,请求也可能藏在转发内容里。我们的目标,是让 Pingbo 按照每位用户自己的需要判断,准确率达到 99.99%。无论检查得多仔细、收集多少新的数据集,都不可能仅靠标准数据集实现这个目标。
只有用户自己知道,哪些邮件该怎么处理。因此,Pingbo 会为每位用户建立判断标准,并持续调整。初次设置时先问几个问题,之后再从你的操作中学习:你回复了一封它没有列进需要你的邮件,不管它当初把这封放到了哪里,这都是它读得到的一个信号,却不等于它判断错了,因为你回了信,不代表这封邮件本来就该回;你没回复就把一封邮件移出需要你,这是另一个信号,同样算不上定论,因为你可能已经把对方要的事办好了。这类信号放在一起看、随时间累积,才会让判断标准向你靠拢,让表 1 中的取舍随你的需要持续调整。
Pingbo 会不断学习你重视什么,并据此调整处理邮件的方式。当它说有事需要你,会用发件人的原文说明是谁、提出了什么要求、为什么需要处理,并提前准备好回复内容;当它告诉你这件事可以等,你就能安心地先放到一旁。这样一来,你就能把时间和精力用在真正需要你关注的事情上。
附录:这份评测有多可信
Sappelli 等人的数据集不是为 Pingbo 设计的:它把邮件分成四类,Pingbo 则要判断一封邮件该放进需要你还是等待中。本文的每个数字都以这份数据集为标准,所以在用它评测 Pingbo 之前,得先弄清楚两件事:四分类标签能信到什么程度,以及 Pingbo 实际评分所用的二选一问题相比之下如何。两个人答案相同,不代表答案一定正确。况且在原本的四分类中,两位标注者只对 1,145 封中的 508 封达成一致,一致率是 44%。这些标签有争议的地方,第三位读者多数没有站在它们这一边。换成二选一问题,同样这两个人的一致率高出许多,他们的标签也和收件人实际有没有回信对得上。这两项检查都说不出某一封邮件的答案究竟是对是错。这些检查是怎么做的,要从模型的答题结果说起。
一开始,有些看似模型答错的结果让我们起了疑心。我们请 32 个模型按照原研究的四个类别,为同一批 508 封邮件分类。其中最接近数据集答案的八个模型,任两个模型平均有 78% 的邮件分类相同,但每个模型与数据集答案相符的比例平均只有 63%。如果只是模型能力不足,错误通常会比较分散:它与其他模型、与标注者的分歧应该差不多。但这八个模型却反复给出相同答案,而标注者认为那些答案是错的。模型答得一致,并不能证明它们就是对的,它们也可能犯同一个错;但这已经足以让我们回头再检查一遍那些标签。
我们找出八个模型全都与数据集答案不同的 57 封邮件,重新进行盲评。所有答案都隐去来源,再混入 43 封模型与数据集原本就一致的邮件。负责评分的模型也在这 32 个模型之中。那 43 封说明它确实读了邮件和答案,而不是随便作答;但不能说明它没有偏袒模型,因为这 43 封上,模型和数据集的答案本来就一致。直到 100 封全部评完,才揭示答案来源。图 A1 是结果。
在有争议的邮件中,评分模型有 45 次认同其他模型,5 次认同数据集,7 次两边都不认同;在没有争议的 43 封中,则全部认同数据集。如果抛一枚公平硬币 50 次,出现 45 比 5 这样悬殊、或更悬殊的结果,大约 2.4 亿次才会遇到一次。统计学把这种概率称为 p 值。这次二项检验的结果是 4.2e-9,远低于常用阈值 0.05。这里有两点要说明。其一,这 57 封是分歧最大的例子,并非随机抽样,所以这只能说明两边在哪些地方分歧最大,既不能推算各自在其余邮件上的错误率,也不能说明哪一边是对的。其二,盲评时过长的邮件会在 4,000 个字符处截断,100 封里有六封达到了这个长度,在这六封上,评分模型读到的内容比其他模型少。
所以数据集并非完全不能用,而是四个类别分得太细,连标注者自己也很难达成一致。1,145 封邮件中,两人都给出分类的有 1,115 封,其中 607 封意见不同。这 607 封里,有 138 封是两人都认为需要回复,只是对现在回还是晚点回看法不同;另外 134 封则都认为不用回复,只是对是否需要阅读有不同判断。这 272 封虽然被分进不同类别,但在“是否需要回复”上,两人其实看法一致。只问是否需要回复时,两人在 1,115 封中有 780 封看法一致,一致率是 70%。
当然,两个人看法一致,也不代表一定正确。因此我们找了一个与标注者无关的事实来核对二选一标签:收件人到底有没有回信。Enron 档案保留了每封邮件之后的往来邮件,只要有收件人在 30 天内又发出主题相同、或引用了原邮件的信,就算作回复。这个判断比较粗略:档案没有记录邮件之间的回复关系,收件人把邮件转发给别人也会被算作回复;我们找到的 115 封回复里,有 72 封只靠主题相同判定。此外,如果收件人自己发出的邮件根本没有收进档案,我们就看不到他有没有回信,没有回信也就不能当作证据。所以我们先只看收件人出现在档案自带员工名单上的 209 封。
如果标签和实际回信毫无关系,标为需要回复和不需要回复的两组邮件,收到回复的比例应该差不多,差距会接近零。结果并非如此:数据集标为需要回复的邮件,有 51.8% 真的得到回复,其余邮件只有 24.8%,相差 26.9 个百分点。由于只根据有限的邮件估计,这个差距的 95% 置信区间是 12.3 到 42.1 个百分点,下限仍在零以上。如果把在档案中发过任何邮件的收件人都算进来,共 491 封,差距缩小到 14.3 个百分点,置信区间是 6.2 到 22.4 个百分点,下限同样大于零。换句话说,被标为需要回复的邮件确实更常收到回复。这是整批邮件上呈现出来的关联,并不能证明其中某一封的标签就是对的。
第三种算法把所有能看到回复的邮件都算进来,共 257 封,差距扩大到 33.6 个百分点。我们把它放在最后说,因为这一组邮件的挑选,部分取决于我们正在检验的那个答案。同样这些邮件上,八个模型多数决答案的差距较小:209 封上是 14.8 个百分点,257 封上是 23.0,491 封上是 5.5。两个置信区间只要有重叠,就说不出哪一边的差距更大,所以我们把两边的答案逐封配对,直接比较这两个差距。三组邮件上都是数据集的差距更大,依次多出 12.1、10.6 和 8.8 个百分点。这三个差值各自也有置信区间,下限都在零以上:209 封上是 0.6 到 24.2 个百分点,257 封上是 0.3 到 21.2,491 封上是 3.0 到 14.7,其中前两个只是勉强越过零。有关联也不等于每一封都对:标签记录的是发件人希望收到回复,收件人却可能太忙没回,所以一封没人回的邮件,不代表它标错了。
二选一的标签也不是毫无瑕疵。重新盲评的 100 封里,有 24 封改用评分模型自己的答案后,连是否需要回复都会跟着改变。有几封邮件在数据集里出现了不止一次,所以这 24 封对应评分所用 508 条记录中的 26 条,占 5.1%。这个数字只是我们查出来有疑问的邮件数量,不是对标签错误率的估计:这 100 封本来就是挑分歧最大的,负责评分的又是另一个模型,其余 395 封则再也没有重看过。它们能说明的是,在这份数据集上接近满分的成绩,不宜看作精确数字。
那么,这份数据集值不值得拿来评测?就它的四分类标签而言,不值得,本文也没有哪个分数是按它们打的:两位标注者自己只对其中 44% 达成一致,而在分歧最大的地方,第三位读者以 45 比 5 站到了模型那一边。换成本文实际评分所用的二选一问题,也就是“这封邮件是否需要回复”,几项检查给出的结论正好相反。同样这两个人,在这个问题上的一致率是 70%。他们的标签也和收件人实际有没有回信对得上,三种算法划出的三组邮件上都是如此。而且这种对应比八个模型多数决的答案更明显,这一项比较才是关键:标签如果不比模型更准,就没有资格用来给模型打分。
以上没有一项能证明某一封邮件的标签就是对的,这里的检查也做不到:它们都是间接的,重新盲评的那 100 封挑的是分歧最大的邮件,剩下的 395 封始终没有再读过。但合起来看,这份数据集拿来评测是够用的,只是它分得清几封邮件的差距,分不清一封:评分所用的 508 条记录里有 26 条存疑,所以一个模型只比另一个多对一两封,并不算领先。本文的每个数字,都该按这个尺度来读。